Experimenter: il tool di Weka per automatizzare le sperimentazioni
Un sistema di Knowledge Discovery in Data (KDD [1] [4]) è composto da un insieme di componenti che tutte insieme possono identificare ed estrarre relazioni dai dati memorizzati nella base di dati che siano nuove, utili ed interessanti.
Dato un Training set e delle classi definite dall'utente, un sistema di Data Mining può costruire molte descrizioni. Alcune di queste sono più corrette di altre, cioè alcune di esse classificano meglio gli esempi sconosciuti. Una volta definita una misura di qualità di una descrizione, la costruzione di una descrizione può essere espressa come un problema di ricerca:
trovare la migliore descrizione nell'insieme delle descrizioni costruibili
Per questo scopo Weka[2][3] mette a disposizione l'Experimenter: si tratta di una versione batch dell'Explorer, e consente di impostare veri e propri esperimenti di Data Mining. Ad esempio, è possibile effettuare una serie di analisi su vari insiemi di dati e con svariati algoritmi, ed eseguirle alla fine tutte insieme, facilitando un confronto tra i vari tipi di algoritmi, per determinare qual è il più adatto a risolvere uno specifico problema.
Distribuire il processo su più macchine
Una caratteristica notevole dell'Experimenter di Weka è che può splittare un esperimento e distribuirlo su più processi. Questa caratteristica è fornita per gli utenti avanzati di Weka ed è disponibile scegliendo "Advanced" dal pannello Weka Experiment Environment.
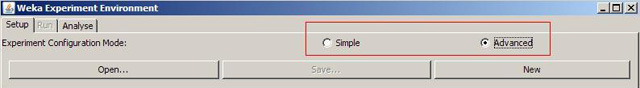
Alcuni utenti evitano di lavorare con questo pannello regolando l'esperimento sulla versione semplice e commutando alla versione avanzata per distribuirla. Tuttavia, la distribuzione di un esperimento è una caratteristica avanzata ed è spesso difficile da realizzare. La distribuzione dell'esperimento funziona al meglio quando i risultati sono trasmessi ad una base di dati centrale: selezionando la base di dati con JDBC per definire la destinazione dei risultati dal pannello dell'interfaccia dell'experimenter. Alternativamente, potreste conservare su ogni host i relativi risultati per poi fonderli in seguito. Per distribuire un esperimento, ogni host deve avere Java installato, deve possedere i corretti grant sui dataset di riferimento e deve far girare il pacchetto weka.experiment (compreso nel workbench Weka). Per iniziare un esperimento "a distanza" su una macchina ospite, è necessario copiare il file remoteExperimentServer.jar dalla distribuzione di Weka su una directory dell'host.
"Spacchettare" il file con: java xvf remoteExperimentServer.jar
Si espande a due file: remoteEngine.jar, un jar eseguibile che contiene il server dell'experimente, e remote.policy.
Il file remote.policy assegna il permesso all'engine remoto per effettuare alcune operazioni, come il collegamento alle porte o l'accesso alle directory. Deve essere editato per specificare i percorsi corretti in alcuni dei permessi; ciò è evidente quando esaminate la file:
grant {
  // allow the remote engine to replace the context class loader.
  // This enables the unloading of types from the remote engine
  permission java.lang.RuntimePermission "setContextClassLoader";

  // file permission to load server classes from remoteEngine.jar.
  // only needed if RemoteEngine_Skel.class/_Stub.class are going to
  // be downloaded by clients (ie, if these files are not already in the
  // client's classpath). Normally this doesn't need to be changed.
  permission java.io.FilePermission "/home/johndoe/remote_engine/-", "read";
};
Avvio del server remoto:
java -classpath remoteEngine.jar:<path_to_any_jdbc_drivers> \
  -Djava.security.policy=remote.policy \
  weka.experiment.RemoteEngine
Avvio del client Experimenter:
java -Djava.rmi.server.codebase=<URL_for_weka_code> \
  weka.gui.experiment.Experimenter