Introduzione alla tecnica dell'Object Pooling in Java: come migliorare le prestazioni delle applicazioni attraverso il riutilizzo di oggetti costosi da creare, con particolare attenzione alla gestione delle connessioni a database e ai problemi di sincronizzazione.
Anche i programmatori Java più freschi di corso, prima o poi, hanno sentito parlare di una delle tecniche più utili per migliorare le prestazioni di una applicazione: il pooling.
Applicare questa tecnica non è molto complesso, come vedremo in questo primo articolo di carattere introduttivo, ma richiede una certa attenzione ad alcune problematiche non del tutto banali. Delle une e degli altri vedremo degli esempi nel prossimo articolo.
Vi è mai capitato di aver bisogno, nell'ambito di una applicazione, di un certo numero n di oggetti di una stessa classe? Direi che non è una evenienza rara.
Se, ad esempio, dobbiamo creare n oggetti di una classe ClasseQualsiasi, la soluzione più diretta è istanziarli quando servono:
public class ClasseQualsiasi
{
    private String attributo1 = "";
    private int attributo2 = 0;

    public ClasseQualsiasi(String att1, int att2){
       attributo1 = att1;
       attributo2 = att2;
    }

   /*codice

   .........................................

   */

}
In molti casi questa soluzione è perfettamente accettabile. In altri casi, però, la creazione dell'oggetto può essere un'operazione onerosa, oppure può essere necessario controllare con precisione quanti oggetti sono disponibili contemporaneamente.
Un esempio classico è quello delle connessioni a database. Aprire una connessione può richiedere molto tempo, e ripetere questa operazione a ogni richiesta può penalizzare pesantemente le prestazioni dell'applicazione. In una servlet, per esempio, aprire e chiudere una connessione per ogni accesso può trasformarsi rapidamente in un collo di bottiglia.
L'idea del pooling è quindi semplice: invece di creare e distruggere continuamente gli oggetti, se ne crea in anticipo un certo numero e li si riutilizza. Quando un oggetto serve, viene prelevato dal pool; quando non serve più, viene restituito al pool.
In generale, i motivi principali per scrivere un pool sono due:
migliorare le prestazioni evitando creazioni ripetute di oggetti costosi;
controllare l'accesso a risorse disponibili in numero limitato.
Per poter essere gestiti in un pool, gli oggetti devono però rispettare alcune condizioni:
devono essere riutilizzabili;
l'accesso agli attributi deve essere protetto;
i metodi critici devono essere sincronizzati.
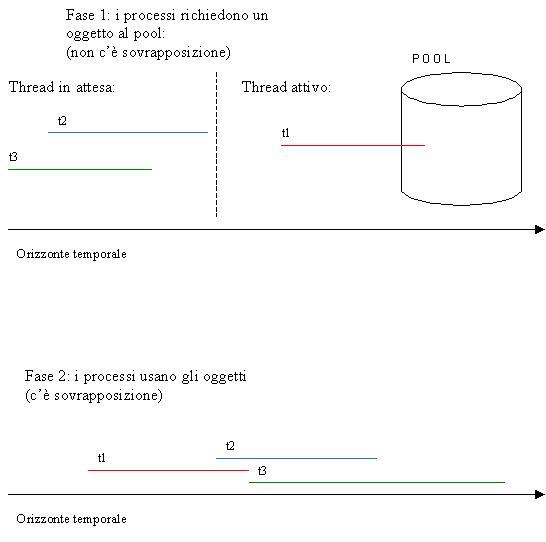
Quando più thread accedono contemporaneamente allo stesso insieme di oggetti, infatti, è indispensabile evitare che due thread utilizzino nello stesso momento lo stesso oggetto. Java fornisce il monitor e la parola chiave synchronized, ma l'ordine con cui i thread in attesa vengono risvegliati dipende dalla Java Virtual Machine: può essere FIFO, LIFO o seguire altre politiche.
Possiamo quindi definire un pool come un insieme non ordinato di istanze della stessa classe, governato da una struttura che permette di sapere quali oggetti sono disponibili e quali sono in uso.
Per prima cosa introduciamo una classe che rappresenta l'oggetto gestito dal pool:
public class PoolableObject
{
    //variabili istanza della classe
    private Object attributo1 = "";
    private int attributo2 = "";
    private boolean locked = false;
    //inseriamo un attributo che ci verrà utile la prossima volta!!
    private long millis = 0;
    /**
    * Costruttore: inizializza l'oggetto.<br>
    */
    public PoolableObject(Object obj, int n)
    {
        attributo1 = obj;
        attributo2 = n;
        locked = false;
    }

    /**
    * imposta il flag di controllo: serve per simulare un lock sull'oggetto.<br>
    */
    public void setLock(boolean b)
    {
        locked = b;
    }

    /**
    * ottiene lo stato del lock, per vedere se si può usare l'oggetto.<br>
    */
    public boolean getLock()
    {
        return locked;
    }

    /**
    * chiude e/o distrugge l’oggetto.<br>
    */
    public void closePoolableObject()
    {
        ///istruzioni per chiudere e/o distruggere questo oggetto
    }
}
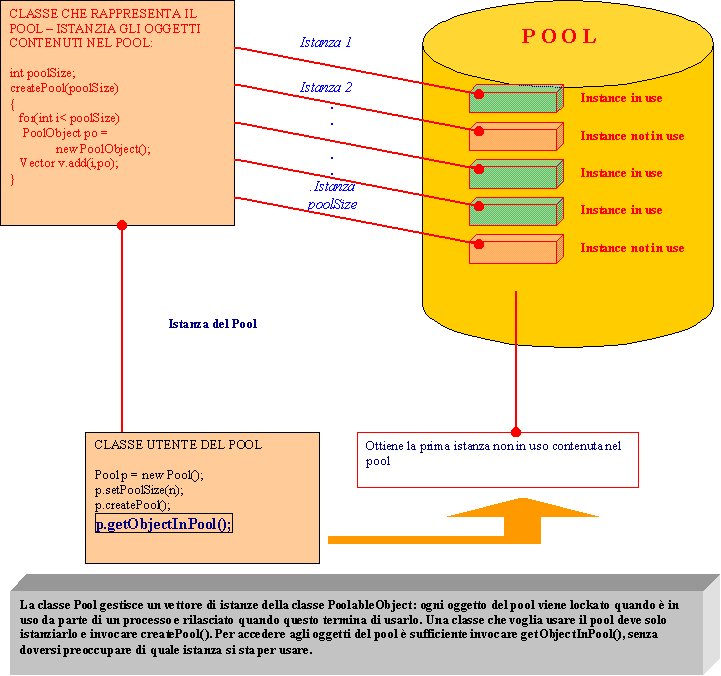
Questa classe incapsula l'oggetto che vogliamo inserire nel pool e mantiene un attributo booleano che indica se l'istanza è già stata assegnata a qualcuno. Nel caso di un pool di connessioni, per esempio, questa classe potrebbe contenere o gestire una connessione verso il database.
Il gestore del pool può essere schematizzato in questo modo:
public class PoolOfPoolableObject
{
    private java.util.Vector pool = null;
    private int poolSize = 0;
    private Object attribute1 = null;
    private int attribute2 = 0;

    public PoolOfPoolableObject(int poolSize){
        this.poolSize = poolSize;
    }
    .............
Per creare il pool inizializziamo il vettore e vi inseriamo il numero stabilito di oggetti:
public synchronized void createPool(){
    if(pool == null){
        pool = new java.util.Vector(poolSize);
    }
    for (int i=0;i < poolSize; i++){
        PoolableObject po = new PoolableObject(attribute1, attribute2);
        pool.add(i,po);
    }
}
Nel nostro esempio il pool ha bisogno soltanto di un vettore e di qualche informazione per costruire gli oggetti. In una implementazione più generale potremmo pensare a una classe astratta o a una gerarchia di classi specializzate per diversi tipi di risorse.
Quando un client chiede un oggetto, il pool deve cercare un'istanza non bloccata, marcarla come occupata e restituirla:
public synchronized PoolableObject getFromPool(){
    PoolableObject po = null;
    for (int i = 0; i< pool.size(); i++){
        po = (PoolableObject)pool.elementAt(i);
        if(!po.getLock()){
            po.setLock(true);
            break;
        }
    }
    return po;
}
Quando il client ha terminato di usare l'oggetto, deve restituirlo al pool:
public void releaseObject(PoolableObject po){
    for (int i = 0; i< pool.size(); i++){
        if(po == (PoolableObject)pool.elementAt(i)){
            po.setLock(false);
            break;
        }
    }
}
Il punto critico è proprio la fase di rilascio. Se tra il prelievo e la restituzione dell'oggetto si verifica un'eccezione, l'oggetto può rimanere bloccato e quindi inutilizzabile per le richieste successive.
Un uso ingenuo del pool può essere il seguente:
try{
  // istruzioni .....

  //ottengo l’ogetto dal pool
  PoolableObject po = pool.getFromPool();
  //istruzioni .....
  //istruzioni .....

  //rilascio l’oggetto al pool
  pool.releaseObject(po);
}
catch(Exception e){
  //gestisco l’eccezione
}
In questo caso, se una delle istruzioni intermedie solleva una eccezione, la chiamata a releaseObject() non viene eseguita. La forma corretta prevede quindi il blocco finally:
try{
  // istruzioni .....

  //ottengo l’ogetto dal pool
  PoolableObject po = pool.getFromPool();
  //istruzioni .....
  //istruzioni .....
}
catch(Exception e){
  //gestisco l’eccezione
}
finally{
  //rilascio l’oggetto al pool
  pool.releaseObject(po);
}
Bisogna inoltre evitare di perdere il riferimento all'oggetto ottenuto dal pool. Un errore come questo può portare al rilascio dell'oggetto sbagliato:
PoolabledObject po = pool.getFromPool();
.....
.....
//ottengo un oggetto di tipo PoolableObject po2
......
po = po2;
//rilascio l’oggetto che avevo ottenuto dal pool
pool.releaseObject(po);
Per ridurre il rischio di oggetti lasciati appesi, una possibile soluzione è introdurre controlli temporizzati, affidati a thread di monitoraggio. Questo aspetto verrà affrontato nel seguito.
La distruzione del pool deve scorrere gli oggetti creati e chiuderli correttamente:
public synchronized void destroyPool(){
    for (int i = 0; i< pool.size(); i++){
        PoolableObject po = (PoolableObject)pool.elementAt(i);
        po.closePoolabelObject();
    }
    pool = null;
    System.runFinalization();
}
}
Prima di distruggere il pool è comunque opportuno verificare che nessun oggetto sia ancora in uso.
Figura 1: Rappresentazione del pool di oggetti
Il modello appena descritto è molto utile in ambito server-side, per esempio in una servlet. Il pool può essere creato nel metodo init(), usato durante le richieste e distrutto quando la servlet viene rimossa dal container.
La servlet può quindi prelevare un oggetto nel metodo service() o nei metodi specializzati doGet() e doPost(). Se più richieste arrivano contemporaneamente, l'accesso al pool deve essere sincronizzato con attenzione.
Figura 2: Accesso concorrente agli oggetti del pool
Il problema non è soltanto creare il pool, ma decidere come reagire quando tutte le istanze sono occupate. Se il pool contiene n oggetti e arriva la richiesta numero n+1, le possibilità sono diverse: attendere che un oggetto si liberi, creare una nuova istanza al volo, oppure ampliare temporaneamente il pool.
Queste scelte dipendono dal tipo di applicazione, dal costo degli oggetti e dal numero massimo di risorse che il sistema può sostenere.
Nel prossimo articolo vedremo un esempio completo di connection pool in una applicazione web e un piccolo esempio di thread pooling.
MokaByte®
è un marchio registrato da MokaByte s.r.l.
Java®, Jini® e tutti i nomi derivati sono marchi
registrati da Sun Microsystems.
Tutti i diritti riservati. E' vietata la riproduzione
anche parziale.
Per comunicazioni inviare una mail a info@mokabyte.it