Parleremo questo mese dell'analizzatore di movimenti di un utente Internet. Nel precedente articolo avevamo fatto una panoramica generale sulla struttura di tale analizzatore. In questo articolo descriveremo più in dettaglio il funzionamento del primo dei tre moduli descritti: il modulo "Proxy".
Come già detto nel precedente articolo, il modulo "Proxy" intercetta i messaggi che il browser e la rete si scambiano durante la navigazione dell'utente. Inoltre si occupa dell'analisi dei documenti HTML che l'utente decide di scaricare e leggere, e di immagazzinare i dati prelevati in una zona di memoria, dove gli altri moduli potranno leggerli per effettuare altre analisi e, infine, aggiornare la banca dati sull'utente.
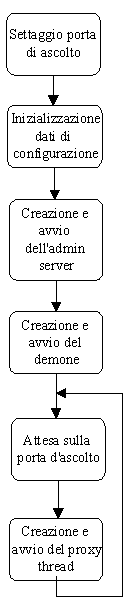
Figura 1: Schema algoritmico della classe ProxyServer
Il proxy è realizzato tramite tre classi principali, che a loro volta utilizzano i servizi di altre classi di appoggio:
1. la classe ProxyServer, che implementa il server per intercettare le richieste in uscita dal browser; 2. la classe Proxy, che implementa il thread per la gestione di ogni singola connessione tra il browser ed un Web server; 3. la classe Config, in cui vengono memorizzati e gestiti i dati di appoggio del proxy stesso, come lista dei siti da monitorare, movimenti effettuati finora dall'utente e configurazione del proxy.
Vedremo ora in particolare la realizzazione di queste tre classi.
Classe ProxyServer
Il ProxyServer ha una struttura algoritmica molto semplice: ha una porta d'ascolto, che se non è specificato diversamente da linea di comando è per default la porta 8080; una volta avviato crea un oggetto della classe Config che inizializza con i valori mantenuti nel file Config.txt; inoltre crea e fa partire due thread: l'admin server e il demone.
// Crea e inizializza il Config
// per configurare il proxy
config = new Config();
(...)
File adminDir = new File("");
config.setAdminPath(adminDir.getAbsolutePath());

// Si crea il thread adminServer
AdminServer adminSrv = new AdminServer(config);
adminSrv.start();

// Si caricano i parametri salvati della config
configFile = new File("Config.txt");
if (configFile.exists()) {
  long length = configFile.length();
  if (length > 0) {
    byte data[] = new byte[(int) length];
    FileInputStream inputFile = new FileInputStream(configFile);
    inputFile.read(data, 0, (int) length);
    String configParameter = new String(data);
    if (configParameter.length() > 0)
      config.parse(configParameter);
    inputFile.close();
  }
}

// Si crea il daemon-thread
daemonThd = new DaemonThread(config);
daemonThd.start();
Quindi il server si mette in ascolto sulla porta scelta, in attesa di una richiesta da parte del browser. Quando arriva tale richiesta, il proxy server crea un nuovo thread, cioè un oggetto della classe Proxy, a cui passa la gestione della richiesta con il socket di comunicazione e l'oggetto Config con i parametri di configurazione; quindi torna in attesa sulla porta di ascolto.
// Si crea il socket principale
mainSocket = new ServerSocket(proxyServerPort);
System.out.println("Proxy attivo...");

// Main loop
while (true) {
  // Si ascolta sul socket
  Socket clientSocket = mainSocket.accept();
  // Si passa la richiesta ad un nuovo proxy thread
  Proxy thd = new Proxy(clientSocket, config);
  thd.start();
}
Questo ciclo continua fino a che il proxy server non viene chiuso dall'esterno o interviene una eccezione. In questo caso, prima di chiudersi, il proxy server attende che tutti i thread lanciati si siano conclusi e che la configurazione mantenuta nella classe Config sia stata salvata nel file Config.txt, per essere recuperabile alla nuova apertura del proxy server stesso.
catch (Exception e) {
  System.out.println(e.toString());
}
finally {
  // Si aspetta che tutti i proxy-thread terminino
  System.out.println("Attesa...");
  while (config.getThreads() > 0) {}
  config.setServerAlive(false);
  System.out.println("Salvataggio informazioni...e chiusura ProxyServer");
  try {
    mainSocket.close();
    // Si salva la configurazione nel file Config.txt
    configFile = new File("Config.txt");
    FileOutputStream outputFile = new FileOutputStream(configFile);
    outputFile.write(config.toString().getBytes());
    outputFile.close();
    System.out.println("Salvataggio dati nel DB Utenti");
    daemonThd.interrupt();
    daemonThd.join();
  } catch (Exception e) {
    System.out.println(e.toString());
  }
}
Classe Proxy
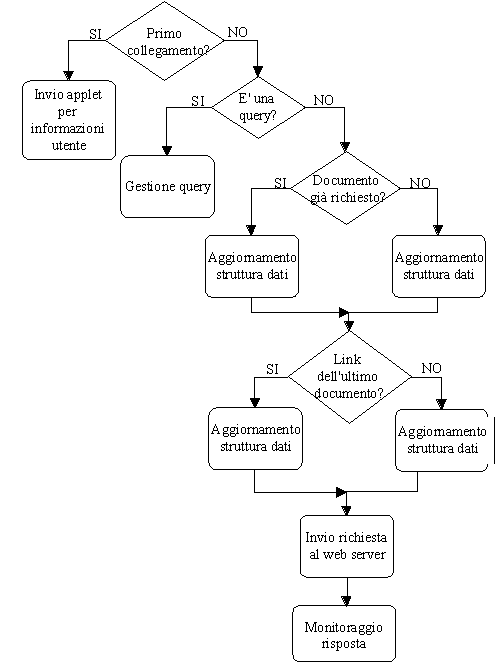
La classe Proxy rappresenta il proxy vero e proprio che si occupa di gestire lo scambio di messaggi tra il browser e il Web server. L'algoritmo seguito dal proxy è schematizzato in figura 2.
Figura 2: Schema algoritmico della classe Proxy
Dopo una prima fase di inizializzazione delle variabili, il proxy avvia un parsing della richiesta che dal browser deve arrivare al Web server. Questo lavoro viene effettuato tramite i metodi messi a disposizione dalla classe HttpRequestHdr, che effettua il parsing dell'header del messaggio secondo le specifiche del protocollo HTTP/1.1.
Una volta effettuato il parsing, si controlla di che tipo di richiesta si tratta. Ci sono due possibilità:
1. la richiesta è per il proxy stesso: in questo caso si tratta di una richiesta dell'amministratore del proxy per cambiarne la configurazione. Il proxy allora invia come risposta un applet che servirà all'utente per modificarne la configurazione; 2. la richiesta è per un Web server esterno: in tal caso il proxy controlla se il sito a cui fa riferimento è uno di quelli da monitorare e, se necessario, aggiorna i dati della sessione dell'utente prima di inoltrare la richiesta.
La parte iniziale del parsing della richiesta è la seguente:
// Parsing dell'header della richiesta del client
request = new HttpRequestHdr();
request.parse(clientIn);
url = new URL(request.getUrl());
isLastMessage = request.getIsLastMessage();

// se è una richiesta dell'amministratore del proxy...
if (url.getFile().equalsIgnoreCase("/admin") &&
    (url.getHost().equalsIgnoreCase(localHostName) ||
     url.getHost().equalsIgnoreCase(localHostIP))) {
  // ...si manda al client la pagina HTML contenente l'applet
  // per gestire il proxy
  sendAdminPage();
}
Nel caso di richiesta verso un sito da monitorare, il proxy controlla se l'utente debba essere registrato per la prima volta nella banca dati, ed eventualmente invia al browser un applet per raccogliere i suoi dati personali. Se la richiesta riguarda un file, si controlla poi se questo sia già stato richiesto altre volte dall'utente e si aggiorna di conseguenza la struttura dati interna all'oggetto Config. Analogamente si verifica se il file richiesto sia un link del documento che l'utente stava leggendo fino a quel momento.
// è una richiesta ad un web-server
{
  hostIndex = config.isInHostList(url.getHost());

  // se è un sito da monitorare...
  if (hostIndex > -1) {
    body = new HtmlResponseBody(config, url.toString(), hostIndex);
    docIndex = -1;

    // ...se non è un sito già sotto osservazione...
    if (!config.isObserved(hostIndex)) {
      // ...si invia la pagina contenente
      // l'applet per il riconoscimento dell'utente
      sendUserInfoPage(hostIndex, request);
      config.setLastSession(hostIndex);
      config.setIsObserved(hostIndex, true);
      isLastMessage = true;
    } else {
      // sito già sotto monitoraggio
      // si può inviare la richiesta del client
      if ((query = getQuery(url.toString())).length() > 0) {
        (...) // non gestita
      } else if (request.getMethod().equalsIgnoreCase("GET")) {
        docIndex = config.isInDocList(url.toString(), hostIndex);
        if (docIndex > -1) {
          if (docIndex == config.getLastFatherDoc(hostIndex))
            config.updateInterestFactor(hostIndex, docIndex, 2);
          else
            config.updateInterestFactor(hostIndex, docIndex, 1);
        } else {
          docIndex = config.insertIntoDocList(url.toString(), hostIndex);
        }

        linkIndex = config.isInLinkList(url.toString(), hostIndex);
        if (linkIndex > -1) {
          config.updateLinkList(linkIndex, hostIndex);
          config.setLastFatherDoc(config.getLinkFatherDoc(hostIndex), hostIndex);
        } else {
          config.setLastFatherDoc(-1, hostIndex);
        }
      }
    }
  }
}
Se il proxy può effettivamente inoltrare la richiesta, crea il socket verso il web server, o verso un eventuale proxy padre, quindi invia l'header ed il resto del messaggio:
if (!isServerSocketAlive)
  if (config.getIsFatherProxy())
    serverSocket = new Socket(config.getFatherProxyHost(),
      config.getFatherProxyPort());
  else {
    serverName = url.getHost();
    serverSocket = new Socket(serverName(request.getUrl()),
      serverPort(request.getUrl()));
    request.setUrl(serverUrl(request.getUrl()));
  }
serverOut = serverSocket.getOutputStream();
serverDataOut = new DataOutputStream(serverOut);
serverDataOut.writeBytes(request.toString(true));
serverDataOut.flush();
Una volta arrivata la risposta, il proxy effettua un parsing dell'header tramite i metodi della classe HttpResponseHdr. Si controlla poi se il file è un HTML ed eventualmente si effettua un parsing del corpo del messaggio, secondo le specifiche HTML 4.0, tramite i metodi della classe HtmlResponseBody. In questo modo si prelevano i link presenti all'interno del documento HTML e si aggiorna di conseguenza la struttura dati del proxy. Inoltre si inserisce all'interno del file HTML un applet nascosto, oggetto della classe TimeCounter, che servirà a calcolare il tempo che l'utente impiega per leggere il documento stesso.
L'applet TimeCounter è molto semplice: alla sua attivazione inizia a contare il tempo che scorre. Quando l'utente cambia pagina, l'applet si ferma, ma non prima di aver calcolato il tempo totale di lettura e di averlo inviato al proxy tramite il modulo admin server.
// gestione risposta dal web-server
serverIn = serverSocket.getInputStream();

// parsing dell'header della risposta del server
response = new HttpResponseHdr();
response.parse(serverIn);
if (!isLastMessage)
  isLastMessage = response.getIsLastMessage();

// se il message body non è vuoto ed è completo...
if ((response.getStatusCode().indexOf("200") > -1) ||
    (response.getStatusCode().indexOf("304") > -1)) {
  // ...se è la risposta ad una GET...
  if (request.getMethod().equalsIgnoreCase("GET")) {
    // se non è codificato...
    if (!response.getIsMessageEncoded()) {
      // ...se è un file HTML...
      if ((response.getContentType().toLowerCase().indexOf("text/html")) > -1) {
        config.saveLinkList(hostIndex, docIndex);
        if (!config.isParsed(hostIndex, docIndex)) {
          String bodyMess = getRestOfResponseMessage(serverIn);
          body.parse(bodyMess);
        } else {
          config.loadLinkList(hostIndex, docIndex);
          body.setMessageBody(getRestOfResponseMessage(serverIn));
        }
        int newLength = body.insertApplet(hostIndex, docIndex,
          config.getLocalHost(),
          config.getAppletUrl(hostIndex),
          config.getAdminPort());
        response.setContentLength(newLength);
        htmlMonitor = true;
        clientDataOut = new DataOutputStream(clientOut);
        clientDataOut.writeBytes(response.toString(true));
        clientDataOut.writeBytes(body.getMessageBody());
        clientDataOut.flush();
      }
    }
  }
}
Se, invece, la richiesta è per un sito Web che non deve essere monitorato, allora il proxy non fa altro che inviare la richiesta al web server corrispondente e, una volta avuta la risposta, effettua un parsing del suo header per poi inviarla al browser che l'ha richiesta.
Classe Config
Infine l'autore descrive brevemente anche la classe Config, che gioca un ruolo molto importante nella gestione dei dati che si riescono a prelevare dall'analisi del comportamento dell'utente. In essa sono mantenuti tutti i dati che conseguono dall'analisi dei vari movimenti che l'utente effettua durante la navigazione.
Questa classe contiene fondamentalmente due tipi di dati:
1. dati di configurazione del proxy; 2. dati di memorizzazione dei movimenti dell'utente.
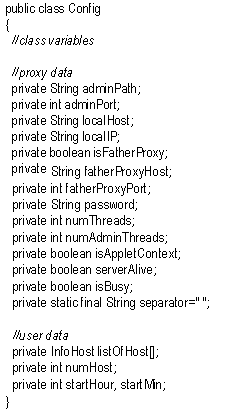
Nella prima categoria rientrano sicuramente l'indirizzo dell'host in cui gira il proxy, la sua porta di ascolto, l'indirizzo e la porta di un eventuale ulteriore proxy a cui passare le richieste, invece di indirizzarle direttamente al web server, ed altri dati di questo tipo.
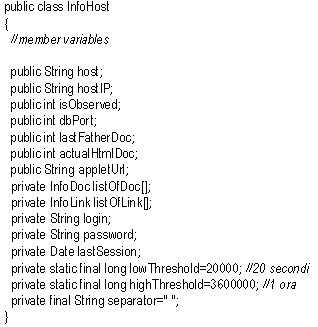
Alla seconda categoria appartiene invece il vettore di oggetti della classe InfoHost, che rappresenta la lista di siti che devono essere monitorati. Ogni oggetto InfoHost contiene una serie di informazioni associate al singolo sito Web da monitorare. Tra queste informazioni, oltre all'indirizzo Internet dell'host, sono presenti i dati personali dell'utente, i valori soglia entro i quali si ritiene corretto il calcolo del tempo di lettura dei file da parte dell'utente, e due liste di oggetti. La prima è una lista di documenti, oggetti della classe InfoDoc, in cui si mantengono tutti i file del sito che l'utente ha richiesto fino a quel momento. La seconda rappresenta la lista di link, oggetti InfoLink, presenti nell'ultimo file HTML aperto dall'utente in quel sito.
Figura 3: Struttura logica della classe Config
Ognuna di queste liste viene di volta in volta aggiornata dal proxy, man mano che esso analizza i file letti dall'utente, in modo tale da avere sempre la situazione aggiornata sui suoi movimenti durante la navigazione all'interno del sito.
Figura 4: Struttura della classe InfoHost
I sorgenti
Cliccando sul file webnet2_sorgenti.zip allegato all'articolo è possibile scaricare i sorgenti.
Conclusione
Anche per questa puntata l'autore rimanda il completamento del quadro generale agli articoli successivi. L'obiettivo dichiarato è chiaro: arrivare a realizzare un analizzatore del comportamento di un navigatore Internet capace di combinare intercettazione del traffico, parsing dei documenti HTML e aggiornamento progressivo di una base dati sui movimenti dell'utente.
MokaByte®
è un marchio registrato da MokaByte s.r.l.
Java®, Jini® e tutti i nomi derivati sono marchi
registrati da Sun Microsystems.
Tutti i diritti riservati. E' vietata la riproduzione
anche parziale.
Per comunicazioni inviare una mail a info@mokabyte.it