Abbiamo visto nel numero precedente qual è stato il percorso nell'evoluzione del web che ci ha portato alla situazione attuale, nonche' quali possono essere gli eventuali sviluppi in tale ambito. Avevamo inoltre iniziato a illustrare, in maniera sintetica, novità e caratteristiche di HTML5, CSS3 e JS API.
È arrivato il momento di cominciare a guardare in dettaglio determinati aspetti tecnici di questa "terna" tecnologica: chiaramente non è possibile separare in compartimenti stagni HTML5 da CSS3 e dalle API JavaScript. In questa parte, affronteremo il discorso concentrandoci sugli elementi strutturali del linguaggio, mentre nelle puntate successive daremo risalto agli aspetti visuali e grafici (molto innovativi e interessanti), e agli elementi legati al comportamento dell'applicazione e all'interazione utente (visto che si va verso un'esperienza sempre più "rich").
Una piccola nota operativa per comprendere al meglio gli esempi riportati in questa serie: indipendentemente dal loro browser preferito, consigliamo ai lettori di utilizzarne uno sufficientemente "HTML5-ready" fra tutti quelli disponibili (quindi, in pratica, per ora Google Chrome, Safari o Opera), per poter visualizzare al meglio gli esempi cui faremo riferimento.
I fondamenti del linguaggio
Iniziamo il percorso di esplorazione di HTML5 analizzando i principi che hanno guidato il team di sviluppo per la definizione delle nuove specifiche del linguaggio. Il primo obiettivo del WHATWG [1] si può intuire già confrontando il doctype della nuova versione del linguaggio
<!DOCTYPE html>
con quello delle versioni precedenti (ad esempio quello di XHTML 1.0 Strict)
<!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Strict//EN" "http://www.w3.org/TR/xhtml1/DTD/xhtml1-strict.dtd">
Il doctype della versione 5 stupisce per l'assenza di un qualsiasi richiamo alla versione in uso e per la mancata indicazione del DTD (Document Type Definition). Con questa semplificazione della scrittura si è voluto evidenziare il carattere di continuità tra le varie versioni del linguaggio. In effetti, se si esclude l'importanza che l'indicazione del corretto doctype riveste ai fini della validazione del documento, i browser riescono a renderizzare correttamente la maggior parte degli elementi HTML presenti in specifiche differenti da quella indicata nel doctype. I browser devono supportare le funzioni del linguaggio e non i doctype, tranne nel caso del "doctype switching" [2], un hack piuttosto diffuso tra i web designer.
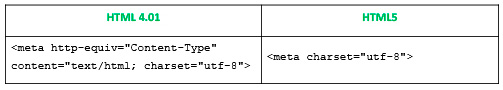
Il processo di semplificazione del linguaggio prosegue anche all'interno del documento, quando si tratta di indicare il set di caratteri con un meta tag (senza dover utilizzare ulteriori attributi tranne il "charset").
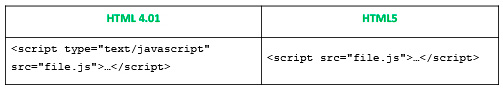
Si semplifica anche quando si deve utilizzare l'elemento <script> per inglobare porzioni di codice JavaScript (senza dover utilizzare l'attributo "type").
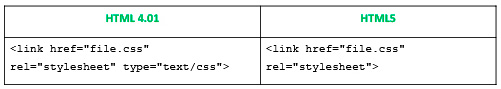
E, infine anche quando si cerca di collegare CSS esterni (anche in questo caso senza l'attributo "type").
Anche la scrittura del linguaggio risente, non senza una certa preoccupazione del sottoscritto, di un processo di semplificazione e di tolleranza della sintassi (in opposizione al rigore formale di XHTML). In HTML5 non è importante scrivere i tag in minuscolo, agli attributi non deve necessariamente essere associato un valore, ne' questo deve obbligatoriamente essere inserito tra virgolette, e i tag vuoti possono essere inseriti senza il simbolo "/" di chiusura come appare nella tabella in basso.
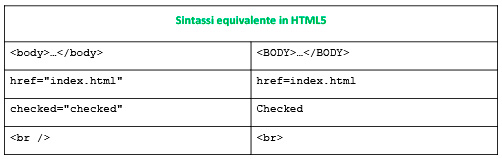
Cambia anche la definizione di elemento HTML deprecato. In passato tali elementi uscivano dalle specifiche del linguaggio: chi continuava ad utilizzarli perdeva la possibilità di validare il documento. Adesso il tag caduto in disuso è definito obsoleto, il browser deve renderizzarlo in un certo modo, ma è tenuto a conservarne la compatibilità, anche se ne viene sconsigliato l'uso. Gli sforzi maggiori del WHATWG per lo sviluppo del nuovo linguaggio [3] sono concentrati proprio nella definizione della corretta gestione degli errori da parte dei browser, in modo da evitare agli sviluppatori di doversi muovere in una jungla di comportamenti proprietari.
Elementi semantici: il linguaggio che spiega se stesso
Dal confronto del linguaggio HTML con XML, una cosa appare immediatamente chiara: la possibilità di creare marcatori secondo i propri bisogni dà a XML un'enorme flessibilità, rendendolo utile per gli impieghi più disparati. Tali elementi, sviluppati ad hoc, hanno un chiaro valore semantico [4] che li rende immediatamente riconoscibili e associabili al loro contenuto (possiamo immaginare di indicare l'autore di un articolo marcandolo con un elemento <author> o il suo indirizzo di posta elettronica con <email>). Il rovescio della medaglia di questa estensibilità è dato dalla necessità di istruire un software (il parser XML) circa il significato degli elementi creati, mentre i browser sanno riconoscere e trattare in modo nativo il ristretto range degli elementi HTML (o almeno dovrebbero farlo...).
Il bisogno di nuovi elementi semantici in HTML è stato finora affrontato ricorrendo a una pratica che si è consolidata fino a sistematizzarsi in una serie di convenzioni che prendono il nome di Microformats [5]. Questi formati utilizzano l'attributo class (un "core attribute" quindi applicabile a tutti gli elementi HTML) e gli associano un valore convenzionale in modo che opportuni programmi possano estrarre i dati semantici presenti nel documento. A seguire un esempio che rispetta il modello Microformat "hCard", specifico per la descrizione dei contatti di una rubrica.
<div class="vcard">
<div class="fn">Mario Rossi</div>
<div class="org">MARIOROSSI SPA</div>
<div class="tel">000 1234567</div>
<a class="url" href="http:// www.mariorossispa.com /">
http:// www.mariorossispa.com /</a>
</div>
Un altro metodo utilizza RDFa (Resource Description Framework -in- attributes), una specifica del W3C che permette di inserire metadati all'interno dei documenti web utilizzando i namespace. Lo strumento risulta essere estremamente efficace, ma introduce un livello di complessità nuovo per un linguaggio che nasce per essere sviluppato in maniera relativamente semplice.
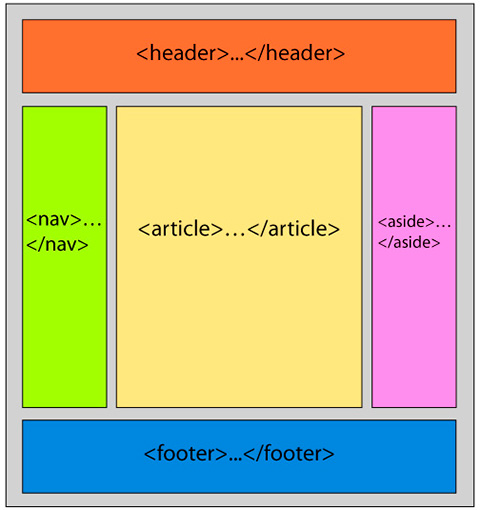
A questo punto, HTML5 introduce nelle sue specifiche una serie di nuovi tag di tipo semantico che forniscono un notevole ausilio nella definizione della struttura del documento. Questi elementi prendono spunto dalla pratica consolidata dei designer di marcare le varie sezioni di un documento HTML con attributi di tipo class aventi per valore nomi estremamente significativi circa il loro posizionamento e il loro utilizzo (come header, footer, nav, section, etc.).
Niente di più ovvio quindi che si sia proceduto alla trasformazione di questi valori in veri e propri elementi strutturali presenti nelle nuove specifiche del linguaggio.
Header
<header>...</header>
Con questo elemento si raggruppano i contenuti presenti nell'intestazione del documento HTML e più in generale nell'intestazione di ogni sezione del documento stesso.
Footer
<footer>...</footer>
Con questo elemento si raggruppano I contenuti presenti nel piè di pagina del documento HTML e più in generale nel piè di pagina di ogni sezione del documento stesso.
Section
<section>...</section>
Con questo elemento si raggruppano le sezioni logiche del documento HTML.
Aside
<aside>...</aside>
Con questo elemento si raggruppano i contenuti secondari del documento HTML, quelli che di solito vengono inseriti nelle barre laterali.
Nav
<nav>...</nav>
Con questo elemento si raggruppano gli elementi che definiscono le sezioni di navigazione di un layout web.
Article
<article>...</article>
Con questo elemento si definisce il contenuto completo di un'articolo, raggruppando i tag che definiscono il titolo, i paragrafi, gli autori e tutte le altre informazioni utili.
Come già accennato giova ricordare che, anche se l'utilizzo prevalente di questi tag è quello di definire le macrosezioni di un layout HTML, come indicato in figura 5, ogni sottosezione del layout, ogni articolo, e più in generale qualunque raggruppamento di elementi può avere il suo header e il suo footer in modo da strutturare i contenuti in maniera estremamente precisa.
<article>
<header>
<h1>Titolo dell'articolo</h1>
</header>
<p>Testo dell'articolo</p>
<footer>
<p>Disclaimer dell'articolo</p>
</footer>
</article>
I nuovi tag di HTML5, pur sviluppando ed estendendo le caratteristiche del linguaggio, presentano maggiori problemi di retrocompatibilità (ma anche di compatibilità in avanti verso browser meno aggiornati alle nuove specifiche) rispetto all'utilizzo di attributi semantici su elementi HTML "standard" (in pratica la strada percorsa dai Microformats).
Web Forms 2.0: la potenza è niente senza il controllo
Il titolo di questo paragrafo richiama il nome di uno dei due documenti (l'altro è Web Apps 1.0) proposti dal WHATWG di Ian Hickson nel 2004 per definire un modello di estensione per l'HTML. Da ciò risulta evidente l'interesse per lo sviluppo di controlli avanzati che potessero rendere i moduli (form) HTML uno strumento più completo e performante nelle funzioni di interazione con gli utenti. Allo stesso tempo si è cercato di semplificare tutta una serie di processi di validazione dei dati lato client: in pratica sono compiti sottratti a JavaScript, che se ne occupa attualmente, in un'ottica di evoluzione dichiarativa del linguaggio HTML.
Di seguito presenterò una rassegna delle tipologie di input più interessanti tra quelle sviluppate dal gruppo di ricerca per l'HTML5; in allegato (menu in alto a sinistra), c'è il file con il codice di tutti gli esempi proposti, anche con riferimento alle diverse figure pubblicate. Nel testo (e nel nome dei file nell'allegato) è riportato il browser nel quale quel particolare form funziona meglio, visto che allo stato attuale, non tutti i browser implementano il supporto per ciascun form.
Campi di ricerca
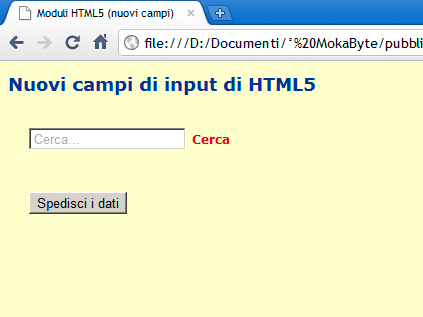
<input id="search" name="search" type="search" placeholder="Cerca...">
<label for="search">Cerca</label>
Il campo di ricerca (type="search") non è altro che un campo di testo che i browser possono visualizzare con lo stile dei campi di ricerca presenti all'interno del sistema operativo utilizzato.
Campi per i dettagli dei contatti
<input id="email" name="email" type="email">
<label for="email">Indirizzo e-mail</label>
Campo di input predisposto per l'inserimento di indirizzi e-mail.
<input id="website" name="website" type="url">
<label for="website">Sito web</label>
Campo di input predisposto per l'inserimento di URL web.
<input id="phone" name="phone" type="tel">
<label for="phone">Telefono</label>
Campo di input predisposto per l'inserimento di numeri di telefono.
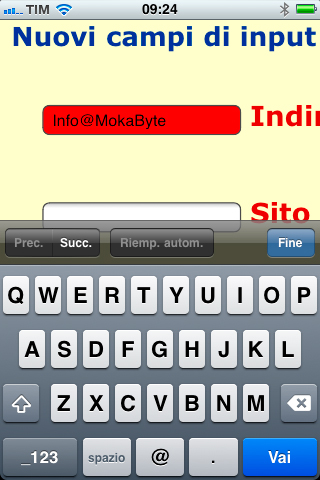
Anche i campi specifici per l'inserimento di indirizzi email, web e numeri di telefono si presentano come campi di testo, ma è importante sottolineare l'informazione semantica che trasmettono al browser che li renderizza [6]. Questa informazione può essere utilizzata, come nel caso del browser Safari per iPhone, per presentare all'utente la corretta tipologia di tastiera con cui inserire i dati, come appare nell'immagine sottostante: nel caso di dati di testo, viene presentata la tastiera con le lettere, mentre nel caso di numeri verrebbe presentato il tastierino numerico.
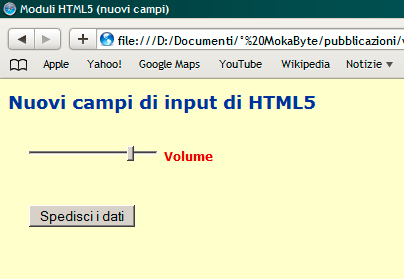
Campi di tipo "slider"
<input id="volume" name="volume" type="range" min="0" max="10" value="8">
<label for="volume">Volume</label>
Con i campi di tipo slider (già presenti in alcune librerie JavaScript ) si aggiunge un certo grado di interattività alle pagine web. Questo controllo potrà essere utilizzato, come avremo modo di apprezzare negli esempi dei prossimi articoli, per gestire lo scorrimento di gallerie di immagini e in numerosi altri contesti. Il range di default del campo va da 0 a 100, ma tale valore può essere regolato attraverso gli attributi min e max. I browser che non riescono a renderizzare correttamente l'input, lo visualizzeranno come un campo di testo contenente il numero.
Campi di tipo "spinner"
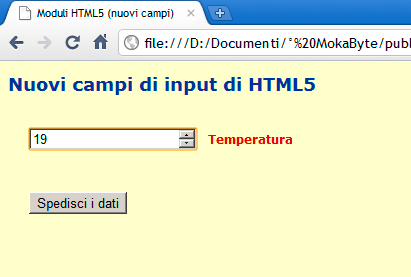
<input id="temp" name="temp" type="number" min="8" max="30">
<label for="temp">Temperatura</label>
Il campo di tipo spinner risulta utile ogni qualvolta si debba produrre un input numerico che è possibile incrementare o decrementare, rimanendo all'interno di un range, stabilito anche questa volta dagli attributi min e max. È possibile inserire i dati numerici digitandoli direttamente nel campo, oppure utilizzare i pulsanti a freccia presenti a lato del controllo per aumentare o diminuire il valore.
Inserimento di date e orari
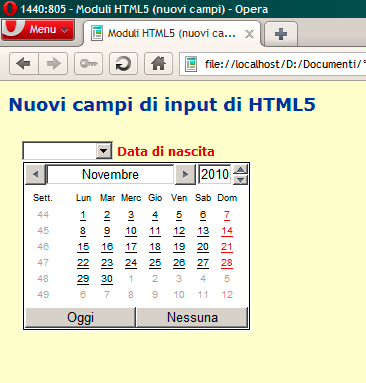
<input id="birth" name="birth" type="date">
<label for="birth">Data di nascita</label>
Questo campo di input nasce per poter inserire correttamente (soprattutto in termini di formato) le date e gli orari all'interno di un modulo HTML. La sua evoluzione più naturale, presente ad oggi solo sul browser Opera, prevede la comparsa di un widget a forma di calendario quando si attiva il campo, in modo da permettere la migliore esperienza utente e, al contempo, ridurre le possibilità di errore nell'input.
Campi di scelta per i colori
<input id="eyecolor" name="eyecolor" type="color" placeholder="valore esadecimale">
<label for="eyecolor">Colore occhi</label>
Allo stato attuale, questa tipologia di input richiede l'inserimento di un valore esadecimale per la scelta di un colore: probabilmente in futuro si evolverà verso forme più "amichevoli" di interazione con l'utente, diventanto molto simile nella forma e nella sostanza ai classici selettori dei colori "a tavolozza", tipici dei software grafici.
<< fig11_colori-Safari.jpg - Figura 11 - Ecco come si presenta il controllo relativo ai colori nel browser Safari. >>
### Campi a tendina "rinvigoriti"
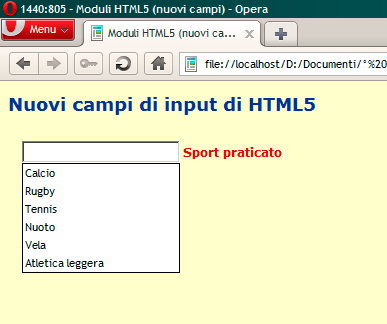
<input type="text" name="mysport" id="mysport" list="sport">
<datalist id="sport">
<option value="Calcio">
<option value="Rugby">
<option value="Tennis">
<option value="Nuoto">
<option value="Vela">
<option value="Atletica leggera">
</datalist>
<label for="mysport">Sport praticato</label>
Quante volte nella progettazione di un modulo HTML abbiamo dovuto inserire la dizione "altro, specificare..." seguita da un campo di testo, per consentire agli utenti di aggiungere valori non previsti all'interno di un menu a tendina? Questo controllo, di fatto, integra in un solo campo le caratteristiche di un menu (con gli opportuni vincoli nella scelta) con la libertà di input propria di un campo di testo. Purtroppo, al momento attuale, la compatibilità dell'elemento <datalist> risulta sostanzialmente limitata ad Opera.
Controlli aggiuntivi per i campi di input
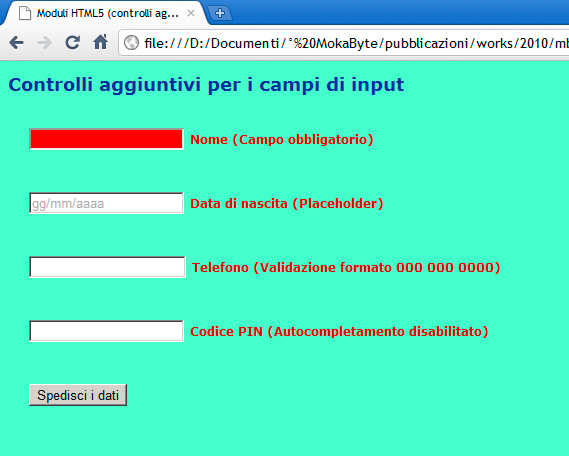
Anche i campi di input presenti nelle specifiche odierne del linguaggio beneficiano delle funzioni aggiuntive che sono presenti in HTML5. Per realizzare queste funzionalità fino ad oggi abbiamo dovuto sviluppare algoritmi JavaScript che effettuassero controlli lato client sui dati immessi, in modo da specificare all'utente quali campi dovesse obbligatoriamente riempire e con quali dati. Con HTML5 è generalmente sufficiente inserire uno o più attributi all'interno dei campi di input per attivare queste funzionalità.
È infatti possibile immettere un testo di default all'interno dei campi semplicemente con l'attributo placeholder:
<input id="datanascita" name="datanascita" type="text" placeholder="gg/mm/aaaa">
Si può anche definire un campo di testo come obbligatorio (anche se questa caratteristica non è ancora supportata dai browser), magari evidenziando il comportamento con una opportuna formattazione attraverso i CSS:
<input id="name" name="name" type="text" required>
Una altra caratteristica apprezzabile è quella che permette di disabilitare la funzione di autocompletamento dei campi: presente in tutti i browser, spesso utile, talvolta fastidiosa, in alcuni casi l'autocompletamento può risultare potenzialmente pericoloso per la sicurezza dei dati (password, codici bancari, etc.). Si può disabilitare tale funzione per tutti i campi del modulo, settando l'attributo autocomplete su off all'interno dell'elemento <form>, come si può notare nell'esempio sottostante
<form name="form2" method="get" action="" autocomplete="off">
oppure si può definire lo stesso attributo solo per alcuni campi di input
<input id="pin" name="pin" type="text" autocomplete="off">
Quando sono necessarie validazioni più accurate dei dati lato client è possibile inserire l'attributo pattern direttamente nel codice degli input HTML. Questo attributo richiede come valore lo stesso tipo di espressioni regolari che abitualmente inseriamo negli algoritmi di validazione sviluppati in JavaScript [7].
<input name="phone" id="phone" type="tel" pattern="\^\\(?\\d{3}\\)?[-\\s]\\d{3}[-\\s]\\d{4}.\*?\$" />
Conclusioni
HTML5 si sta sviluppando come un linguaggio che recepisce ciò che di buono è stato realizzato in questi anni nello sviluppo del World Wide Web e acquisisce come standard il lavoro di gruppi esterni come Microformats per la definizione degli elementi semantici. In questo modo le buone pratiche, dopo essersi evolute in consuetudini, acquisiscono la dignità di standard.
HTML5 è un linguaggio che incrementa notevolmente le potenzialità dei moduli web e definisce una serie di controlli utili anche ad altri scopi (si pensi all'uso degli slider per lo scorrimento delle gallerie fotografiche). Anche i processi di validazione lato client delle form risultano notevolmente semplificati, con la possibilità di inserire le espressioni regolari direttamente nel codice HTML.
Resta il dubbio relativo al fatto che il linguaggio possa perdere le caratteristiche di rigore che erano proprie della sintassi di XHTML, con il rischio concreto che a pagarne il conto sia, oltre alla leggibilità del codice, la possibilità di produrre output conformi e omogenei nei vari browser, anche in vista dell'integrazione più stretta con il "codice rigoroso" di CSS e JavaScript.
Riferimenti
- [1] Il sito del WHATWG
http://www.whatwg.org/
- [2] Un approfondimento sul "Doctype Switching"
http://www.webdevout.net/doctype-switching
- [3] La recentissima Editor's Draft di Ian Hickson sul sito del W3C
http://dev.w3.org/html5/spec/Overview.html
- [4] Un articolo sulle semantica di HTML5
http://www.alistapart.com/articles/semanticsinhtml5/
- [5] Il sito di Microformats, una risorsa per la definizione di elementi semantici
http://microformats.org/
- [6] Jeremy Keith, "HTML5 for Web Designers", A Book Apart, 2010
- [7] Il sito di HTML5Rocks che fornisce una nutrita serie di esempi
http://www.html5rocks.com/