if (ejbHome == null) { throw new ServiceLocatorException("Could not get home for " + ejbName); } return ejbHome; } catch (NamingException ne) { throw new ServiceLocatorException(ne.getMessage()); } }
public static EJBLocalHome getEjbLocalHome(String ejbName) throws ServiceLocatorException { try { Object object = context.lookup(ejbName); EJBLocalHome ejbLocalHome = null; ejbLocalHome = (EJBLocalHome) object; if (ejbLocalHome == null) { throw new ServiceLocatorException("Could not get local home for " + ejbName); } return ejbLocalHome; } catch (NamingException ne) { throw new ServiceLocatorException(ne.getMessage()); } }
public static Object getJNDIObject(String objectName) throws ServiceLocatorException { Object object; try { object = context.lookup(objectName); if (object == null) { throw new ServiceLocatorException(msg); } return object; } catch (NamingException ne) { throw new ServiceLocatorException(ne.getMessage()); } }
public static synchronized ServiceLocator getInstance() throws ServiceLocatorException { if (serviceLocator == null) { serviceLocator = new ServiceLocator(); } return serviceLocator; }
public static synchronized ServiceLocator getInstance(Properties jndiProperties) throws ServiceLocatorException { if (serviceLocator == null) { serviceLocator = new ServiceLocator(jndiProperties); } return serviceLocator; }
private Context getInitialContext(Properties jndiProperties) throws NamingException { if (jndiProperties == null){ throw new NamingException("Impossibile inizializzare il context JNDI se jndiProperties è nullo"); } Context context = new InitialContext(jndiProperties); return context; }
private Context getInitialContext() throws NamingException { Context context = new InitialContext(); return context; }
}
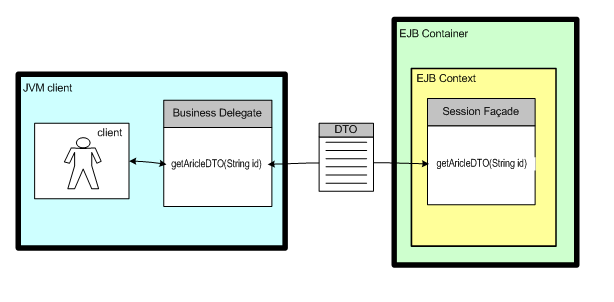
La propagazione dei dati fra strati differenti: il pattern DTO Uno dei problemi più frequenti da risolvere quando si devono mettere in comunicazione strati ap-plicativi differenti e' quello di trasferire le informazioni fra i vari layer che compongono l'ap-plicazione nel complesso. Spesso la comunicazione fra i layer applicativi avviene tramite un qualche protocollo di comunicazione remota (come RMI/IIOP, CORBA, SOAP) secondo un approccio che tende a semplificare la costruzione dell'architettura nel suo complesso, ma che ovviamente introduce un costo in termini di performance. Si immagini la comunicazione che si instaura fra un client EJB ed il relativo session bean remoto; si ipotizzi che in un determinato momento della esecuzione del client, questo debba ricavare una serie di informazioni relative a una qualche struttura dati remota. Per esempio, quando un client deve ricavare le informazioni di una entità individuata per chiave primaria, potrebbe aver bisogno di reperire gli attributi diretti della entità come invece delle informazioni conservate nelle strutture dati collegate all'entità principale (ossia oggetti dipendenti, secondo il classico schema master-detail). Dato che si sta operando in uno scenario distribuito, appare evidente come sia particolarmente scomodo (per il programmatore) e costoso (in termini di tempo di esecuzione) eseguire tante invocazioni remote per ottenere tutte le informazioni in maniera spicciola, ad esempio invocando uno per volta i seguenti metodi:
public String getAttributeA(String id); public String getAttributeB(String id); public String getAttributeC(String id); public String getAttributeDependent(String id);
L'invocazione dei metodi remoti di un EJB comporta il transito di informazioni sullo strato di rete, per cui è preferibile ridurre al minimo le chiamate remote verso il session bean. Dato che non si vuole legare lo strato EJB con quello invocante è necessario trovare un sistema per estrapolare i dati dallo strato server per passarli al client chiamante. La soluzione a questo semplice problema è quella di trasferire le informazioni dall'entità ad un oggetto serializzabile (in modo da trasferirlo in rete come parametro di risposta del metodo remoto del session), ed inviare tale oggetto dal server verso il client. In questo modo si potrebbero sostituire le "n" invocazioni del caso precente con la sola
public myDTO getAttributes(String id);
Questo schema porta alla realizzazione di un oggetto detto Data Transfer Object (pattern DTO), che può essere realizzato tramite due soluzioni: utilizzare un DTO basato su strutture dati generiche (pattern GenericDTO) o uno appositamente costruito (CustomDTO). Nel primo caso tutte le informazioni dell'utente verranno estrapolate dall'entità server side ed inserite in una collezione di qualche tipo (usualmente un oggetto di tipo Properties o Hashtable) presente fra le librerie standard del JDK: in questo modo sia il client che il server dispongono del bytecode di questo generic DTO per cui le operazioni di serializzazione e deserializzazione così come il processo di trasferimento in rete potrà essere effettuato senza problemi. Lo svantaggio di questa soluzione è che non offre nessun supporto sul controllo dei tipi e dei nomi dei campi: ad esempio il ricevente del DTO non può avere la certezza della presenza di un campo "attributeABC" al posto di "attributeAbc" o semplicemente "attribute_abc". Il DTO generico quindi rappresenta una soluzione semplice ma non garantisce la correttezza della applicazione se non in fase di esecuzione al verificarsi di eccezioni di tipo NullPointerException. Questo tipo di DTO può essere scomodo da gestire se la struttura dati da trasferire risulta essere particolarmente complessa: si pensi al caso in cui l'oggetto base contenga al suo interno riferimenti ad altri oggetti (dependent objects). In tali casi è preferibile utilizzare un DTO custom, ossia una struttura dati appositamente pensata per trasferire le informazioni dell'entità fra i vari strati: il nome dei campi i tipi e la struttura dati complessiva risulta ben definita sia per il client che per il server e non si potranno avere errori in fase di esecuzione. L'errato accesso ad un campo non correttamente specificato causa un errore in compilazione, che potrà essere facilmente corretto. Il prezzo da pagare in questo caso è dato dalla necessità di distribuire il bytecode della classe DTO su tutti gli strati che la utilizzano. Questo significa che per ogni modifica alla struttura dati del DTO sarà necessario ricompilare e ridistribuire i file .class corrispondenti. Nel caso in cui si decida di optare per un DTO custom, si potrà anche dar vita a una gerarchia di oggetti DTO che partendo dal minimo indispensabile (nel DTO classe base) arrivi fino a un contenitore nel quale inserire tutte le informazioni dell'entità riferita ma anche delle eventuali entità dipendenti. La fantasia del programmatore in questi casi non ha limiti e volendo si possono creare tanti oggetti DTO "tagliati" sulle esigenze dei vari use case che insistono sulla entità di base. Ogni caso d'uso infatti potrà in ogni momento decidere di manipolare o modificare gli stessi dati in modo differente, oppure semplicemente agendo su aggregati differenti dello stesso costrutto base (un po' come avviene per le view di un database). In definitiva non esiste una regola universalmente valida per la scelta fra un DTO generico e un DTO creato ad hoc. Molto dipende dal caso in esame e dalla complessità dei dati. Un DTO preso direttamente dal sistema (in Java dalle librerie del JDK) limita la dipendenza dei vari layer applicativi con la libreria che contiene il DTO: è possibile proseguire con lo sviluppo dei vari componenti senza la paura di rimanere bloccati per le dipendenze che si instaurano. Se invece si usa un DTO personalizzato, si ottiene un oggetto di trasporto altamente specializzato che permette di rispondere esattamente alle esigenze specifiche del problema; di conseguenza, però, siamo in presenza di un oggetto che, essendo spostato fra i vari strati del sistema, di fatto introduce un legame logico fra i vari layer. Una corretta separazione dei vari cicli evolutivi dei vari contesti coinvolti (i layer in contrapposizione con il DTO) consente di limitare i problemi.
Conclusioni Si conclude con questo articolo la parte della serie dedicata all'analisi delle architetture e del "pattern programming". Come il lettore potrà aver notato, lo scopo di questi due articoli (la VI e la VII parte) non è stato quello di presentare l'ennesima trattazione dettagliata sul pattern programming, ma piuttosto mostrare come la definizione di una architettura enterprise possa essere arricchita e completata tramite l'uso dei pattern. Parallelamente, questo mese la serie "si sdoppia", con il primo (VIII parte) di una serie di articoli dedicati alla programmazione di applicazioni JavaEE realizzati da Alfredo Larotonda: in questo "binario parallelo" verranno fatte alcune valutazioni in analogia con quelle qui presentate ma con lo scopo di offrire un raffronto con tecnologie concorrenti.
Riferimenti [ADA-1] Lorenzo Bettini, "Il pattern adapter: la teoria", MokaByte 33, Settembre 1999 http://www.mokabyte.it/1999/09/adapter_teoria.htm
[ADA-2] Andrea Trentini, "Il pattern adapter: la pratica", MokaByte 33, Settembre 1999 http://www.mokabyte.it/1999/09/adapter_pratica.htm
[PRX-1] Lorenzo Bettini, "Il pattern Proxy: la teoria", MokaByte 31, Giugno 1999 http://www.mokabyte.it/1999/06/proxy_teoria.htm
[PRX-2] Andrea Trentini, "Il pattern Proxy: la pratica", MokaByte 31, Giugno 1999 http://www.mokabyte.it/1999/06/AT_Proxy.html
[SL] Stefano Rossini, "Il Pattern Service Locator", MokaByte 66, Ottobre 2002 http://www.mokabyte.it/2002/10/pattern_sl.htm