Introduzione
L'utilizzo dell'associazione qualificata, sebbene possa creare qualche perplessità iniziale, ha un campo di azione piuttosto ben definito: è utilizzata in tutti quei casi in cui vi è una struttura di lookup da una parte della relazione. Ciò equivale anche a dire che, dal punto di vista dell'implementazione, la relazione dovrebbe essere realizzata per mezzo di opportuni oggetti che agevolino la ricerca, come Hashtable, Map, ecc. Caratteristica peculiare di tali oggetti è la realizzazione di un mapping tra un identificatore e un oggetto. Per esempio, la classe Hashtable in Java possiede i seguenti metodi per memorizzare e reperire oggetti:
put(key:Object, value:Object)
get(key:Object )
Pertanto le istanze di questa classe permettono di realizzare un mapping tra un oggetto che rappresenta la chiave (il qualificatore) e un altro che invece rappresenta ciò che si vuole individuare.
Quindi possiamo dire che questa relazione potrebbe essere mappata introducendo una variabile di tipo Hashtable nella classe Beekeeper: tale hashtable permette il reperimento delle varie istanza di Apiary utilizzando una istanza di Intervention come indice. In pratica si avrebbe una situazione come quella raffigurata in figura 2.
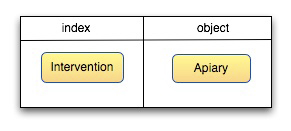
Questa implementazione, per quanto fedele alla modellazione OO, introduce un livello di complessità non facilmente risolvibile con gli attuali motori di persistenza. Il costrutto di "component" offerto da Hibernate potrebbe aiutare in qualche modo. Di certo in EJB 3 non vi sono soluzioni dirette e semplici a questo tipo di problema. Normalmente, quando si presentano casi di questo tipo, conviene riconsiderare il problema cercando di capire se effettivamente quanto si sta cercando di risolvere è realmente necessario. Nel nostro caso potremmo "rifattorizzare" il modello (e quindi capire se l'analisi è modificabile senza stravolgere la natura del progetto), alterando lievemente il modo con cui l'informazione che lega apicoltore e apiario viene mantenuta nel sistema. Se quello a cui siamo interessati è tenere traccia degli interventi che verranno eseguiti in apiario dai singoli apicoltori (ovvero tenere un diario degli interventi eseguiti da "chi" e "dove"), possiamo semplificare il modello, trasformando la relazione qualificata in una semplice relazione con entità di relazione: il legame quindi potrebbe essere disegnato come in figura 3.
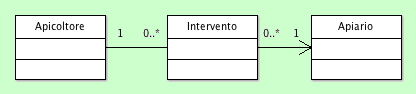
Intervention in questo caso rappresenta la traduzione nel paradigma ad oggetti di quello che in un database è una tabella di cross (necessaria per mappare il legame n-a-m fra apicoltore e apiario): in questo caso si aggiungono alcuni attributi relativi alla associazione, che in gergo si chiamano attributi di link. Ogni istanza di Intervention quindi memorizza un legame fra Beekeeper e Apiary tenendo traccia anche della data di intervento e delle operazioni svolte. Ecco il codice Java della implementazione secondo il modello EJB 3 (si notino le variabili Apiary e Beekeeper che legano l'entità Intervention con gli oggetti dipendenti):
@Entity
@Table(name = "intervention")
@NamedQueries({@NamedQuery(name = "Intervention.findById",
				query = "SELECT i FROM Intervention i WHERE i.id = :id"),
@NamedQuery(name = "Intervention.findByNotes",
		query = "SELECT i FROM Intervention i WHERE i.notes = :notes"),
@NamedQuery(name = "Intervention.findByDate",
		query = "SELECT i FROM Intervention i WHERE i.interventionDate = :date")})
public class Intervention implements Serializable {
private static final long serialVersionUID = 1L;
@Id
@Column(name = "id", nullable = false)
@GeneratedValue(strategy = GenerationType.AUTO)
private Integer id;

@Column(name = "notes")
private String notes;

@Column(name = "date")
@Temporal(TemporalType.DATE)
private Date interventionDate;

@ManyToOne
@JoinColumn(name = "apiary_id", referencedColumnName = "id")
private Apiary apiary;

@ManyToOne
@JoinColumn(name = "beekeeper_id", referencedColumnName = "id")
private Beekeeper beekeeper;

public Intervention() {
}
Considerando il grafico di figura 3, si faccia attenzione alla tipologia di navigabilità: Apicoltore-Intervento è una relazione bidirezionale, mentre Intervento-Apiario è monodirezionale (da Intervento verso Apiario). Se la seconda classificazione trova piena corrispondenza nel modello di analisi, il primo caso è forse un po' meno giustificabile. Il motivo di questa scelta è molto semplice: supponiamo di voler rendere la relazione bidirezionale, ovvero introducendo una variabile di relazione nella classe Beekeeper (che tenga quindi traccia della istanze di Intervention), tale variabile potrebbe essere poi mappata sul database secondo la tecnica del rivesciamento della chiave (vedi l'articolo precedente di questa serie), come mostrato nella seguente porzione di codice:
@OneToMany(mappedBy = "beekeeper")
private Collection<Intervention> interventions;
dove si dice che il legame è gestito dall'altro elemento della relazione. Introducendo questo artefatto, è possibile inserire in Beekeeper il metodo
public Apiary getApiary(Intervention i){
Apiary a = i.getApiary();
return a;
}
Tale metodo, pur nella sua elementare e pleonastica funzionalità, permette di introdurre in Beekeeper la possibilità di reperire l'apiario su cui si è lavorato utilizzando una istanza di Intervention come indice: di fatto è la simulazione del modello hashtable di cui si è parlato poco sopra. Si faccia attenzione che la presenza della variabile intervetions potrebbe rendere del tutto inutile la definizione del metodo getApiary(), dato che in ogni momento infatti potrebbe sempre essere possibile scrivere (N.B.: il metodo getElementAt() non è disponibile per la classe Collection, qui viene introdotto per semplificare la scrittura dell'articolo):
beekeeper.getInterventions().getElementAt(i).getApiary()
Questa scorciatoia, permette di ricavare un apiario tramite l'indice dell'intervento, quindi con un risultato analogo, ma formalmente diverso. Volendo impedire questa violazione, si potrebbe eliminare la variabile interventions: in questo caso il metodo getApiary() dovrebbe effettuare ogni volta una ricerca sullo storage per ricavare prima la particolare istanza di intervention e poi la apiary corrispondente:
public Apiary getApiary(Intervention i){
// l'istanza em EntityManager viene ricavata come variabile
// da un session bean di facade
Intervention i = em.findIntervention(i.getId());
Apiary a = i.getApiary();
return a;
}
Questa opzione introduce un livello di complessità sicuramente maggiore dato dalla necessità di ricavare l'istanza di EntityManager per eseguire la ricerca: in pratica l'entity bean dovrebbe comportarsi come se fosse un session oppure, in alternativa, utilizzarne uno già presente nella applicazione con funzione di facade: la maggior parte dei lettori concorderanno con il fatto che questa sia una inutile complicazione. Il miglior compromesso fra ragione e fedeltà al modello potrebbe essere quello di optare per la introduzione della variabile interventions (in modo da avere a disposizione in Beekeeper la relazione con gli interventi effettuati dall'apicoltore), ma di proibirne l'uso definendola privata e non pubblicato il corrispondente metodo getIntervention().
Modellare la relazione Famiglia-Scheda
Veniamo al secondo caso, la relazione Famiglia con Scheda, entità che a sua volta instaura un legame generalizzazione-specializzazione con SchedaTrattamenti e SchedaSalute: in questo caso si deve gestire una relazione di ereditarietà. La letteratura ci dice che non esiste un solo modo per rappresentare questo genere di legame, essendo disponibili in genere le seguenti possibilità:
- una tabella per entità
- una sola tabella di mapping in fondo alla gerarchia con colonna discriminante
- approccio misto
Queste sono tre alternative tutte valide e la scelta dipende dal contesto: da quanti attributi/relazioni ci sono in comune, da quanto bisogna rilassare i vincoli, dalle tipiche operazioni, e altro ancora. Un modo per sciogliere ogni dubbio potrebbe essere quello di definire i vari attributi, magari specificando il legame per ogni variabile con la colonna della tabella/tabelle, in modo da capire cosa sia possibile portare a fattor comune o cosa invece impedisca una soluzione o un'altra. Tanto per fornire un'idea, se si sceglie di utilizzare una sola tabella per tutte le entità si ottiene un indubbio risparmio di spazio (perche' si limita la ridondanza e la replica di informazioni comuni a entità diverse in diverse tabelle), ma si corre il rischio di non poter applicare tale tecnica se il database non permette di abbassare alcuni vincoli. Si prenda ad esempio lo schema di tabella 1:
Tabella 1
La seconda riga potrebbe rappresentare un'entità in fondo alla gerarchia (quindi con più attributi o colonne) mentre la prima un oggetto in alto nella scala gerarchica degli oggetti: dato che le colonne G H I non assumono alcun valore, quindi si può immaginare che la riga appartenga ad un oggetto che non ha tali attributi. La cosa non è così chiara perche' potrebbe trattarsi di un oggetto in fondo alla gerarchia in cui alcuni campi (ovviamente non obbligatori) non sono valorizzati. La terza riga evidenzia maggiormente questa possibilità. Una semplificazione la si può avere introducendo una colonna che serva per memorizzare il tipo di record salvato, come si vede nella tabella 2:
Tabella 2
Appare chiaro che questo approccio, sebbene porti a una organizzazione dei dati molto compatta (usare una sola tabella non obbliga a ripetere informazioni su tabelle differenti), non è perseguibile nel caso in cui il database abbia regole e vincoli sulle colonne (ad esempio vieti che la colonna G possa essere nulla). Rispetto alla soluzione antagonista (una tabella per ogni oggetto della gerarchia) è una soluzione più solida e resistente alle modifiche e refactoring sugli oggetti: una modifica alla classe base comporta solo l'aggiunta di una colonna alla tabella, mentre nell'altro caso si dovrebbero modificare molte tabelle. Come appare ovvio non esiste una soluzione buona per tutte le stagioni, molti sono i fattori che entrano in gioco. A scopo didattico si è scelto di adottare la soluzione 2 (una tabella per tutte le entità con l'uso della colonna discriminante), in modo da mostrare come gli ORM possano consentire di gestire in modo automatico e intelligente questa situazione. Le tabelle necessarie per gestire questa relazione sono due: FAMILY e REPORT, assumendo che in REPORT mapperemo sia dati relativi a SchedaTrattamenti (entità TreatmentReport ) che SchedaSalute (entità HealthReport). Dal punto di vista dell'organizzazione degli oggetti Java la struttura vede alla base della gerarchia l'entity Report di cui è qui di seguito presentata la parte iniziale (quella relativa alla definizione degli attributi):
@Entity
@Table(name = "report")
@Inheritance(strategy = InheritanceType.SINGLE_TABLE)
@DiscriminatorColumn(name="report_type")
@DiscriminatorValue(value="BAS")
@NamedQueries({@NamedQuery(name = "Report.findById",
			query = "SELECT r FROM Report r WHERE r.id = :id"),
			@NamedQuery(name = "Report.findByReportType",
				query = "SELECT r FROM Report r WHERE r.reportType = :reportType"),
@NamedQuery(name = "Report.findAll",
				query = "SELECT r FROM Report r WHERE r.reportType = 'BAS'"),
@NamedQuery(name = "Report.findByReportDate",
				query = "SELECT r FROM Report r WHERE r.reportDate = :reportDate")})
public class Report implements Serializable {
public static final long serialVersionUID = 1L;
public static final String BASEREPORTTYPE = "BASE";
public static final String HEALTHREPORTTYPE = "HEALTH";
public static final String TREATREPORTTYPE = "TREAT";

@Id
@Column(name = "id", nullable = false)
@GeneratedValue(strategy = GenerationType.AUTO)
protected Integer id;

@Column(name = "report_type", updatable=false, insertable=false)
private String reportType;

@Lob
@Column(name = "notes")
protected String notes;

@Column(name = "report_date")
@Temporal(TemporalType.DATE)
private Date reportDate;

@OneToMany(mappedBy = "report")
private Collection<Family> familyCollection;
La definizione della entità fa uso di particolari annotazioni che, oltre a specificare la tabella di mapping, permettono di specificare la strategia di mapping:
@Table(name = "report")
@Inheritance(strategy = InheritanceType.SINGLE_TABLE)
@DiscriminatorColumn(name="report_type")
@DiscriminatorValue(value="BAS")
La annotazione Inheritance avverte il sistema che il bean appartiene a una gerarchia di oggetti e che la strategia adottata prevede una sola tabelle per tutta la gerarchia. La annotazione DiscriminatorColumn specifica quale colonna usare come discriminante; il valore scelto in questo caso è "BAS" (ovvero oggetto alla base delle gerarchia) come specificato dalla annotazione DiscriminatorValue. Quindi tutte le volte che si procede al salvataggio di una entità di questo tipo, nella colonna "report_type" l'application server (o meglio il motore di mapping), inserisce il valore "BAS". Da notare che la definizione dell'oggetto Report come oggetto persistente non è del tutto aderente a quanto specificato in fase di analisi, dato che nel modello non dovrebbero esistere oggetti Report semplici, ma solo TreatmentReport ed HealthReport,: per questo motivo l'entità Report non dovrebbe mai essere resa persistente. Volendo invece passare alla definizione delle due entità figlie, queste saranno definite in modo da non ripetere le definizioni per gli attributi base (con le relative regole di mapping) che sono invece presenti nell'oggetto padre. Di seguito è riportata la definizione della classe HealthReport (l'altro fratello ha una implementazione del tutto analoga):
@Entity
@Inheritance(strategy = InheritanceType.SINGLE_TABLE)
@DiscriminatorColumn(name="report_type")
@DiscriminatorValue(value="HEA")
@NamedQueries({@NamedQuery(name = "HealthReport.findAll",
					query = "SELECT h FROM HealthReport h"),
			@NamedQuery(name = "HealthReport.findById",
				query = "SELECT h FROM HealthReport h WHERE h.id = :id"),
			@NamedQuery(name = "HealthReport.findByReportDate",
				query = "SELECT h FROM HealthReport h WHERE h.reportDate = :reportDate")})
public class HealthReport extends Report implements Serializable {
private static final long serialVersionUID = 1L;

@Lob
@Column(name = "health_description")
private String healtDescription;

}
Si noti la prensenza delle query in formato EJBQL che consentono la ricerca degli oggetti in base ai vari attributi delle classi: come era logico aspettarsi non è presente la query che consente la ricerca per l'attributo reporttype, essendo un attributo discriminante (e per lo stesso motivo non è necessario definire la regola di persistenza di tale attributo, essendo gestita automaticamente dal framework): il fatto stesso di ricercare un HealthReport implica che si sta eseguendo una ricerca in cui il valore del camp reporttype="HEA".
Conclusioni
In questo articolo abbiamo mostrato come si possano mappare due tipologie di relazione particolare. L'obiettivo al solito non era quello di affrontare in dettaglio la teoria delle varie tecniche di mapping, quanto mostrare, sulla base delle indicazioni scaturite in fase di analisi sia possibile passare alla progettazione ed implementazione nella maniera più fedele possibile. In questo caso si è visto come, queste due tipologie di relazioni, per quanto siano realizzabili nel modello OO, portino con se alcune importanti implicazioni per quanto concerne la parte di mapping sul repository. In entrambi i casi si è visto come adottare un modello a oggetti senza alcun adattamento non sempre sia possibile o ottimale. Nelle prossime puntate inizieremo a parlare dello strato di mezzo, ovvero del layer di business logic.