Metodo di rappresentazione
La rappresentazione che proponiamo nel nostro sistema si basa sull'approccio "bag of word": la vista logica dei documenti è rappresentata da un insieme di parole chiave, le quali possono essere estratte direttamente dal testo della e-mail, senza conoscerne il significato ma facendo riferimento solamente alla morfologia del token estratto. Nella figura viene mostrato il procedimento adottato nell'estrazione delle feature del documento da analizzare.
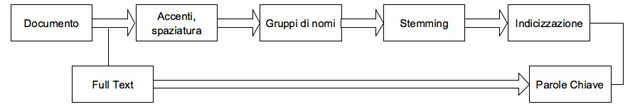
Nella pipeline mostrata in figura, il documento (e-mail) viene elaborato da un processo di "stemming" (o normalizzazione, che riduce diverse parole alla loro comune radice grammaticale, in inglese "stem") e con l'identificazione di gruppi di nomi (che elimina aggettivi, avverbi e verbi). Queste elaborazioni, dette di text operation riducono la complessità della rappresentazione del documento, permettendo di passare dalla vista logica full text (senza alcun processamento) a quella dell'insieme delle parole chiave.
Ipotizzando di dividere il documento in "parole" (word) conosciute e riconoscibili (anche su basi statistiche), possiamo utilizzare la metrica definita da TF-IDF (Term Frequency, Inverse Document Frequency), tecnica statistica utilizzata nell'information retrival e nel text mining. Nel termine TF si evidenzia la frequenza con cui una determinata "parola" appare in un documento; tale valore può anche essere pesato in base a determinati criteri, ad esempio per alleggerire il peso di "parole" ricorrenti. Il termine IDF è la misura del peso del termine, relativamente al corpus dei documenti, e viene ottenuto dividendo il numero di tutti i documenti per il numero dei documenti contenti la "parola" in oggetto, e prendendone il logaritmo.
01
02
Chiaramente è necessario un insieme elevato di stringhe pertinenti (il corpus dei documenti) per avere delle misure valide relativamente a un documento in input. Applicando un vector space model (VSM), nel quale ogni documento è rappresentato da un vettore, dove la dimensione è data dal numero di termini distinti, possiamo utilizzare lo schema TD-IDF insieme al concetto di similarità coseno (descritto nella prima parte) per definire distanze fra documenti. Tipicamente la definizione dei termini dipende dall'applicazione e anche in questo caso le diverse tecniche utilizzate per dimensionare il dominio e separare i termini sono parametri chiave nella determinazione del risultato. Nell'implementazione proposta, il documento da analizzare viene "tokenizzato" (suddiviso in token che nel nostro caso sono parole); dopo aver elaborato (e ridotto) l'elenco delle parole, è necessario indicizzarle. La forma di indice utilizzata è l'inverted index. Un inverted index è un meccanismo orientato alle parole per indicizzare una collezione di testo, al fine di velocizzare l'operazione di ricerca. La struttura dell'inverted index è composta da due elementi: il vocabolario e le occorrenze. Il vocabolario è l'insieme di tutte le parole del testo; per ognuna di queste è conservata una lista di tutte le posizioni nel testo dove essa compare. L'insieme di tutte queste liste viene chiamato occorrenze. Con riferimento all'implementazione proposta la classe 'SparseVector' si occupa della gestione del vettore sparso dove vengono memorizzati i valori di frequenza dei termini;
...
  public void addTerm(String term, double value)
  {

  Double inc = new Double(value);

  if (map.containsKey(term))
  {

      double app = ((Double)map.get(term)).doubleValue()+value;

      inc = new Double(app);

  }

  if (inc>maxValue)
  {

      maxValue = inc;

      maxWord = term;

  }

  map.put(term,inc);

  }

...
public class AnnotedDocs {
private Map<String, MultiLabel> docs; public AnnotedDocs() {
docs = new HashMap<String, MultiLabel>();
} public void addDoc(String name, String label) {
if (docs.containsKey(name)) ((MultiLabel)docs.get(name)).addLabel(label);
else {
MultiLabel ml = new MultiLabel(name,label);
docs.put(name, ml);
}
} public List getLabels(String name) {
return (docs.get(name)).getLabels();
}
}
TRAIN
Sia l'insieme delle categorie {c1,c2,...,cn}
For i from 1 to n leti pi = <0,0,...,0> (inizializzazione)
For each esempio di training <x,c(x)> in D
	Let d = vettore INTRA-CLUSTER/INTER-CLUSTER per il doc x
	Let i = j: (ci=c(x))
		(somma di tutti i vettori in ci per ottenere pi)
	Let pi = pi + d
TEST
Dato un documento di test x
Led d = vettore INTRA-CLUSTER/INTER-CLUSTER per x
Let m = -2 (inizializzazione)
For i from 1 to n:
	(calcola la similarità col vettore prototipo)
	Let s = fuzzySim(d, pi) similarità fuzzy
	if (s>m)
		Let m = s
		Let r = ci (aggiorna il più simile)
Return class r
... public double getMembership(String dictTerm, String category) {
double value = 0.0;
for(int i=0; i<centroids.length; i++) {
Centroid centroid = centroids[i]; if (category.equals(centroid.getCategory())) value = centroid.getSv().getFreq(dictTerm);
}
return value;
} public double sim(Document doc, String category) {
double res = 0.0;
Iterator iter = doc.getSparseVector().getTerms().iterator();
while(iter.hasNext()) {
String word = (String)iter.next(); double mem1 = getMembership(word, category);
double mem2 = doc.getMembership(word);
res = res + Jaccard.jaccardSim(mem1, mem2);
}
return res;
}
...
public class Jaccard
{
private static double getTNorm(double x, double y) {
 ... }

	private static double getTConorm(double x, double y) {
 ... }
public static double jaccardSim(double x, double y) {
 ... }

	{

		double ret = 0.0;
double num = getTNorm(x, y);

		double den = getTConorm(x, y);
if (num!=0 || den!=0)
			ret = getTNorm(x,y)/getTConorm(x,y);
return ret;

	}

}
public class Fusion {
public int a;
public int b;
public int c;
public int d;
public double getRecall()
	{

		return (((double) a)/(double)(a+c));

	}
public double getPrecision()
	{

		return (((double) a)/(double)(a+b));

	}