Il processo per l'estrazione di conoscenza dai dati
I sistemi classici di memorizzazione dei dati, i DBMS (DataBase Management System), offrono un'ottima possibilità di memorizzazione e accesso ai dati con sicurezza, efficienza e velocità ma non permettono un'analisi per l'estrazione di informazioni utili come supporto alle decisioni. Solo negli ultimi anni sono apparse tecnologie in grado di svolgere questo compito, grazie al contributo di diverse discipline quali gli studi su intelligenza artificiale, reti neurali, statistica, apprendimento automatico. Queste tecnologie, applicate alle basi di dati, sono conosciute con i termini di Knowledge Discovery, Knowledge Extraction, Data Archaeology, Data Mining. [1] [4] Questi termini descrivono, almeno in parte, il concetto di "knowledge discovery in databases" (KDD) inteso come processo per l'estrazione di informazioni, o meglio di conoscenze, da grosse quantità di dati. Ecco una definizione comunemente usata: [4]
Per "data mining" si intende il processo di selezione, esplorazione, e modellazione di grandi masse di dati, al fine di scoprire regolarità o relazioni non note a priori, e allo scopo di ottenere un risultato chiaro e utile al proprietario del database.
Il processo per il KDD è costituito da un numero di stadi interattivi che manipolano e trasformano i dati per riuscire a estrarre delle informazioni utili. Nel 1996 Usama Fayyad, Piatetsky-Shapiro e Smyth identificarono cinque passi nel processo per il KDD che di seguito elenchiamo con particolare attenzione allo stadio del Data Mining:
1. Selezione: i dati grezzi vengono segmentati e selezionati secondo alcuni criteri al fine di pervenire a un sottoinsieme di dati, che rappresentano il "target data" o dati obiettivo. 2. Preprocessamento: la fase di pulizia dei dati ("data cleaning") che prevede l'eliminazione dei possibili errori e la decisione dei meccanismi di comportamento in caso di dati mancanti. 3. Trasformazione: quando i dati provengono da fonti diverse, è necessario effettuare una loro riconfigurazione al fine di garantirne la consistenza. 4. DataMining: apprendimento mediante classificazione. Questo schema di apprendimento parte da un insieme ben definito di esempi di classificazione per casi noti, dai quali ci si aspetta di dedurre un modo per classificare esempi non noti. 5. Interpretazione: il sistema di astrazione per la classificazione crea dei pattern, ovvero dei modelli, che possono costituire un valido supporto alle decisioni. Non basta però interpretare i risultati attraverso dei grafici che visualizzano l'output della classificazione, ma occorre valutare questi modelli e cioè capire in che misura questi possono essere utili.
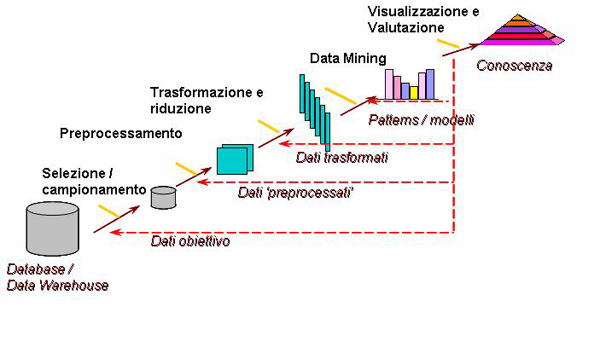
In questo articolo esploreremo con l'aiuto di Weka [2] [3] il processo di selezione, preprocessamento e classificazione.
Algoritmi per la selezione
Esistono varie modalità di selezione degli attributi. Alcune considerano un attributo alla volta e determinano la misura della sua significatività in base alla capacità di discriminare una classe da un'altra. Altre considerano invece una collezione di attributi e ne valutano l'efficacia complessiva. Possiamo prendere come set di dati zoo.arff (fornito come esempio nel framework) e scegliere come valutatore per gli attributi il metodo InfoGainAttributeEval che calcola, per ogni attributo, il guadagno di informazione.
=== Attribute Selection on all input data ===

Search Method:
Attribute ranking.

Attribute Evaluator (supervised, Class (nominal): 18 type):
Information Gain Ranking Filter

Ranked attributes:
2.3906  1 animal
1.3108 14 legs
0.9743  5 milk
0.8657  9 toothed
0.8301  4 eggs
0.7907  2 hair
0.7179  3 feathers
0.6762 10 backbone
0.6145 11 breathes
0.5005 15 tail
0.4697  6 airborne
0.4666 13 fins
0.3895  7 aquatic
0.3085 17 catsize
0.1331 12 venomous
0.0934  8 predator
0.0507 16 domestic

Selected attributes: 1,14,5,9,4,2,3,10,11,15,6,13,7,17,12,8,16 : 17
Per ogni attributo viene visualizzato un punteggio: in questo caso è il guadagno di informazione, a partire dall'attributo che ha il guadagno maggiore fino a quello che ha il guadagno minore. Normalmente tutti gli attributi vengono selezionati, indipendentemente dal valore del punteggio. Tuttavia, modificando i parametri del metodo di ricerca Ranker, è possibile cambiare il comportamento:
- numToSelect: se viene impostato al valore n positivo, indica che si vogliono selezionare solo i primi n attributi in ordine di rilevanza. Se è impostato a un valore negativo, la selezione avviene in base al valore di soglia di cui si parla qui sotto.
- threshold: se numToSelect è negativo, vengono selezionati gli attributi con ranking superiore a questa soglia.
Algoritmi di preprocessamento
In Weka sono disponibili numerosi algoritmi di filtraggio; questi sono accessibili attraverso l'Explorer, il Knowledge Flow e l'Experimenter. Tutti i filtri trasformano il set di dati in qualche modo. Scegliendo il filtro con il bottone "choose" dall'interfaccia dell'explorer, Weka mostra 2 macrotipologie di filtri:
- Supervisionati: esiste un attributo speciale, l'attributo classe, che viene usato per guidare le operazioni di filtraggio
- Non Supervisionati (il processo di training avviene in modo automatico): tratta tutti gli attributi allo stesso modo
Esempi di filtri non supervisionati presenti in Weka sono:
- Discretize: discretizza gli attributi convertendoli da numerici a nominali
- Resample: campionamento con rimpiazzamento dei dati; può funzionare come il metodo non supervisionato oppure è in grado di effettuare il campionamento in modo che l'attributo classe abbia una distribuzione uniforme: ciò avviene impostando a 1.0 il valore dell'attributo biasToUniformClass.
Algoritmi per la classificazione
Nel pannello "Classify" dell'explorer è possibile selezionare un algoritmo di classificazione; essi sono suddivisi in
Analizziamo un insieme di dati zoo.arff con i vari metodi di classificazione conosciuti. Prima di effettuare le varie analisi, discretizziamo il set di dati usando il filtro supervisionato Discretize. In questo modo possiamo utilizzare anche algoritmi che funzionano solo su dati discreti.
Classificatore ZeroR
Viene selezionata come predizione la classe più frequente nel set di dati. Equivale a un albero di classificazione di altezza 0. Accuratezza = 41%
Notare che per ZeroR (e per tutti gli algoritmi di classificazione) è possibile ottenere uno scatter plot, ma con in più l'indicazione se l'istanza è classificata correttamente oppure no. Istanza classificate correttamente sono marcate con '+', mentre le istanze classificate non correttamente sono classificate con un quadratino.
J48 e ID3
Genera un albero di classificazione. Accuratezza: 89%
Naive Bayes
Utilizza il metodo bayesiano con incremento dei contatori di 1, in modo da evitare i problemi che sorgono con probabilità nulle. Accuratezza: 93%
BayesNet
È un metodo per apprendere reti bayesiane. La struttura della rete può essere fissata o può essere appresa dall'algoritmo, e si possono modificare sia l'euristica usata per la ricerca della struttura della rete, sia il metodo usato per stimare le probabilità condizionate. Accuratezza: 95%
IDk
La struttura di Weka
Abbiamo spiegato come invocare il filtraggio (preprocessamento/selezione) e gli schemi di apprendimento con l'interfaccia Explorer; ma per capire a fondo come lavorano gli algoritmi all'interno di Weka dobbiamo esaminare la sua struttura.
Il package weka.core è il nucleo del framework; le classi chiave di weka.core sono le classi per rappresentare dati e istanze.
Il package weka.classifiers contiene gli algoritmi di classificazione e predizione numerica. La classe più importante contenuta nel package è Classifier, la quale definisce la struttura generale di ogni schema di classificazione o di predizione numerica. Classifier contiene tre metodi ereditati in ogni classe che la estende:
buildClassifier(Instances instances): genera/addestra il classificatoreclassifyInstance(Instance instance): classifica un'istanza attraverso il metodo distributionForInstancedistributionForInstance(Instance instance): calcola le probabilità di appartenenza dell'istanza alle classi definite
void buildClassifier(Instances instances)
double[] distributionForInstance(Instance instance)
java.lang.String globalInfo()
static void main(java.lang.String[] argv)
java.lang.String toSource(java.lang.String className)
java.lang.String toString()
Esempio pratico
public class BioClassifier implements Serializable {
  private Instances m_Data = null;
  private StringToWordVector m_Filter = new StringToWordVector();
  private Classifier m_Classifier = null;
  private boolean m_UpToDate;
  private static final String N = "N";
  private static final String NOTN = "notN";

  public BioClassifier() throws Exception {
    m_Classifier = new Id3();
    String nameOfDataset = "BioInformaticsProblem";
    FastVector attributes = new FastVector(2);
    attributes.addElement(new Attribute("dna", (FastVector)null));
    FastVector classValues = new FastVector(2);
    classValues.addElement(N);
    classValues.addElement(NOTN);
    attributes.addElement(new Attribute("Class", classValues));
    // ipotizziamo 100 elementi nel vettore
    m_Data = new Instances(nameOfDataset, attributes, 100);
    m_Data.setClassIndex(m_Data.numAttributes() - 1);
  }

  public void trainN(String dna) throws Exception {
    train(dna, N);
  }

  public void trainNotN(String dna) throws Exception {
    train(dna, NOTN);
  }

  private void train(String dna, String classValue) throws Exception {
    Instance instance = makeInstance(dna, m_Data);
    instance.setClassValue(classValue);
    m_Data.add(instance);
    m_UpToDate = false;
  }

  public String classify(String dna) throws Exception {
    if (m_Data.numInstances() == 0) {
      throw new Exception("No classifier available.");
    }
    if (!m_UpToDate) {
      m_Filter.setInputFormat(m_Data);
      Instances filteredData = Filter.useFilter(m_Data, m_Filter);
      m_Classifier.buildClassifier(filteredData);
      m_UpToDate = true;
    }
    Instances testset = m_Data.stringFreeStructure();
    Instance instance = makeInstance(dna, testset);
    m_Filter.input(instance);
    Instance filteredInstance = m_Filter.output();
    double predicted = m_Classifier.classifyInstance(filteredInstance);
    return (m_Data.classAttribute().value((int)predicted));
  }

  private Instance makeInstance(String text, Instances data) {
    Instance instance = new Instance(2);
    Attribute messageAtt = data.attribute("dna");
    instance.setValue(messageAtt, messageAtt.addStringValue(text));
    instance.setDataset(data);
    return instance;
  }
}