Avete mai navigato in Internet? Domanda retorica, eh!? Eccone allora una un po' più difficile: vi siete mai "persi" all'interno di un sito Web? Avreste mai voluto incontrare una "guida" del sito pronta ad indicarvi la "strada" più breve per arrivare all'informazione che stavate cercando? Quello che presentiamo adesso è uno studio su come monitorare e quindi ottimizzare il cammino di un utente all'interno di una qualsiasi struttura ipertestuale.
Introduzione
Il problema ha stuzzicato molte persone negli ultimi tempi ed in molti hanno anche tentato di risolverlo. Una tra le soluzioni proposte prevede la realizzazione di un agente che, partendo da una banca dati in cui sono mantenute le principali informazioni sugli utenti di un sito, riesce a capire in anticipo gli interessi di un utente e lo guida verso l'informazione cercata.
In questo articolo descriveremo come realizzare un analizzatore dei movimenti di un navigatore di Internet. Tale analizzatore "spia" gli accessi dell'utente ad un preciso sito Web e da essi preleva alcune informazioni che verranno inserite nella banca dati remota sugli utenti.
L'analizzatore ha l'aspetto di un proxy, che si frappone tra il browser dell'utente e la rete. In questo modo ha la possibilità di ricevere ogni messaggio che il browser e la rete si scambiano ed in particolare può vedere quali sono le pagine HTML che l'utente decide di leggere.
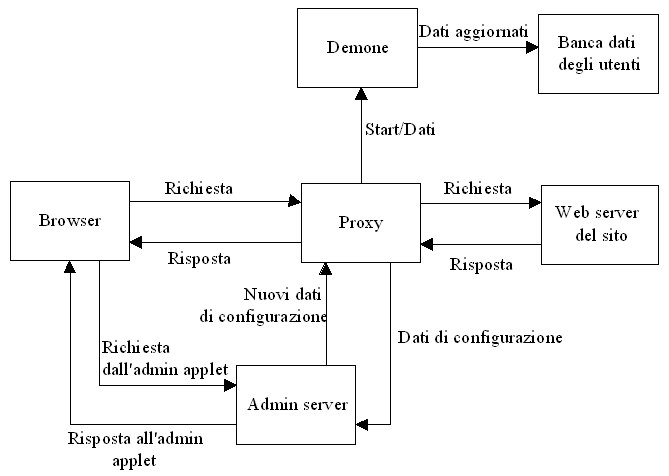
Supponiamo quindi che l'utente decida di accedere ad un documento del sito web tramite il suo browser. A questo punto il browser invia il messaggio HTTP al proxy; questo invia a sua volta il messaggio all'host del sito e riceve il documento richiesto. Il proxy, prima di inviare il file al browser, lo analizza e ne preleva tutte le informazioni necessarie per aggiornare la banca dati dell'utente, e quindi per "capire" quali sono i suoi interessi.
Lo schema generale dell'analizzatore è mostrato in figura 1.
Figura 1: Schema generale dell'analizzatore
Il Proxy
Per quanto riguarda il proxy, per capire quali devono essere le sue funzioni, dobbiamo prima capire cosa intendiamo per "monitorare i movimenti di un utente in un sito Web".
Un primo particolare interessante, che il proxy deve memorizzare, è sicuramente l'indirizzo Web del documento e quindi il nome del file scaricato. Da qui infatti si può risalire ad una precisa informazione o argomento trattato all'interno del documento.
Un altro aspetto importante è che nel documento possono essere presenti dei link e che l'utente può decidere di seguirli o no. Questo è un altro elemento che può essere analizzato per dedurre gli interessi dell'utente.
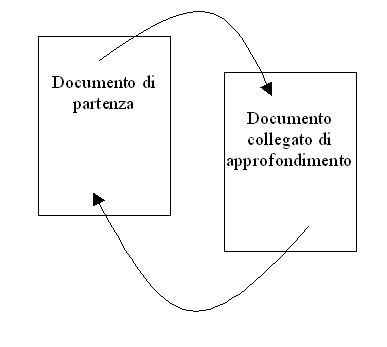
In figura 2 è riportato il primo caso significativo: il fatto che un utente segua un certo link indica sicuramente che vuole approfondire il tema trattato nel documento collegato a quello di partenza. Se, però, l'utente torna indietro al documento iniziale, è un segnale che può significare che l'informazione principale cercata dall'utente si trova nel documento di partenza, e il link è stato seguito solo per un approfondimento.
Figura 2: Navigazione con link seguito e ritorno
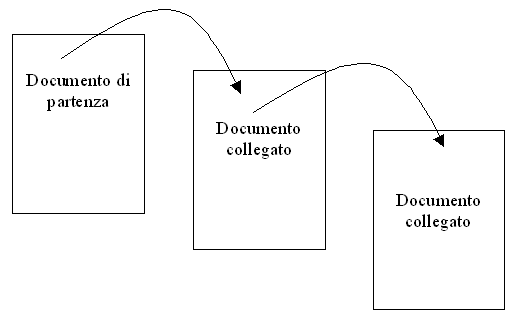
Se, invece, l'utente segue i link "a cascata", muovendosi in profondità da un file all'altro, può significare che l'informazione cercata dall'utente non era nel primo documento da lui richiesto, anche se conteneva un argomento in qualche modo in relazione con l'informazione cercata. In questo caso, infatti, l'utente ha deciso di seguire i link che, secondo lui, più si avvicinano all'informazione voluta, con la speranza di arrivare, alla fine, al documento desiderato.
Da tutto questo si capisce che il modulo proxy deve mantenere in memoria una struttura in cui inserisce, per ogni pagina che analizza, i link che si trovano in essa e, per ognuno di essi, un flag che indica se l'utente li segue o no.
Figura 3: Struttura dati per tracciare i link seguiti dall'utente
Un'altra fonte di informazioni interessanti sul comportamento dell'utente è data dal tempo di lettura della pagina Web scaricata, ossia da quanto l'utente si sofferma su essa. Si può infatti immaginare che, più l'utente si sofferma su un preciso documento, più cresce il suo interesse per il tema in esso trattato.
Bisogna, però, prestare attenzione ad un problema che deriva da questo ragionamento, che può diventare troppo semplificativo nel dedurre gli interessi dell'utente. Bisogna tenere conto del fatto che egli può soffermarsi su un certo documento per leggerlo e studiarlo, nel qual caso le deduzioni sopra esposte risultano fondate; oppure può succedere che in quel momento l'utente si sia allontanato dalla macchina, fortunatamente anche i navigatori più incalliti vanno a mangiare, anche se a volte lasciano il collegamento attivo, e quindi la deduzione fatta prima risulta completamente errata, o comunque priva di fondamento.
Si può cercare di dedurre comunque qualcosa dall'analisi del tempo passato da un utente su un certo documento, tenendo conto però di queste diverse possibilità. Si può pensare, quindi, di aggiornare la banca dati dell'utente solo se il tempo di lettura non supera un "valore soglia massimo", che indicherebbe il fatto che l'utente non sta effettivamente leggendo il documento, ma è impegnato in qualche altro compito, è arrivato il panino che aveva ordinato al bar.
Inoltre, si può decidere di memorizzare come "letta" una pagina solo se il suo tempo di lettura supera un altro "valore soglia minimo", sotto il quale si può pensare che l'utente abbia scaricato il documento sperando di trovarci delle informazioni utili, ma si sia subito accorto di non essere interessato ad esso ed abbia deciso di non leggerlo.
Il proxy quindi deve calcolare il tempo che l'utente impiega per leggere ogni pagina che scarica dal sito Web, tenendo presente i due suddetti "valori soglia".
Un ultimo dato calcolabile dal proxy è quello che deriva dal conteggio del numero di volte che un utente apre lo stesso documento. Il fatto che un file venga scaricato e letto più volte può indicare un notevole interesse da parte dell'utente verso l'argomento in esso trattato.
Gli altri moduli
Descriviamo infine le funzioni svolte dagli altri due moduli.
Il modulo "Admin server" si occupa di amministrare l'analizzatore. Tramite questo modulo si può configurare il proxy, definendo l'indirizzo del sito Web da analizzare, l'indirizzo della banca dati a cui si accede, i "valori soglia" descritti prima ed altri dati di configurazione utili al proxy.
Inoltre il modulo si occupa di gestire la zona di memoria in cui il proxy deve inserire i dati che preleva dall'analisi delle pagine scaricate dal sito. Ogni modulo che deve accedere a tale zona di memoria deve passare attraverso il modulo "Admin server".
Il modulo "Demone", infine, è un modulo che si sveglia una volta al giorno, accede tramite l'Admin server alla zona di memoria in cui sono presenti i dati raccolti dal proxy, li analizza, ne preleva le informazioni necessarie per aggiornare la banca dati sugli utenti ed invia i suoi risultati alla banca dati stessa.
Per ora ci fermiamo qui altrimenti l'argomento può diventare pesante e noioso. Nei prossimi articoli, se sarete ancora interessati, analizzeremo più in dettaglio i vari moduli descritti qui e vedremo un modo per realizzarli in Java e per farli comunicare tra loro.
MokaByte®
è un marchio registrato da MokaByte s.r.l.
Java®, Jini® e tutti i nomi derivati sono marchi
registrati da Sun Microsystems.
Tutti i diritti riservati. E' vietata la riproduzione
anche parziale.
Per comunicazioni inviare una mail a info@mokabyte.it