
Uno degli argomenti più caldi legati a Java ed internet è la gestione dei dati attraverso applet/applicazioni Java. Dato che all fine della stesura del presente articolo era forse eccessiva per un solo numero, ho pensato di frazionare il tutto in due parti: questo mese affronteremo alcuni concetti basilari come client server e modello a 2 e 3 strati, mentre nel numero successivo affronteremo i dettagli tecnici del package JDBC presente nel JDK 1.1.
Le nuove JDBC API contenute nel JDK 1.1 rilasciato da Sun agli inizi di questanno, forniscono un set completo di routine per laccesso a basi di dati. Precedentemente al rilascio di queste librerire, per poter gestire archivi da un applicativo Java, era necessario ricorrere a sistemi misti che facevano uso di strati di software scritti in linguaggi strettamente legati allhardware, come il C, con ovvi problemi di portabilità. Le soluzioni attualmente più usate non escludono la possibilità di coesistenze fra parti di codice scritto in Java con moduli scritti in linguaggi legati allhardware sottostante (senza compromettere la portabilità di Java), ma senza dubbio il poter disporre delle potenzialità di un linguaggio ad alto livello come Java semplifica enormemente le cose. Questo tipo di discorso è equivalente a quanto è accaduto per la gestione dei socket con il JDK 1.0: a parte le enormi potenzialità del write once run.... di Java, implementare una connessione via socket in C richiede mediamente un bel po di lavoro aggiuntivo e qualche mal di testa in più (come amano sottolineare i testi americani).
Luso della tecnologia Java per la realizzazione di applicazioni portabiliì da un lato, e ladozione degli standard più diffusi per la comunicazione con DBMS (primo fra tutti il supporto di uninterfaccia per il linguaggio SQL), rende questo pacchetto di API veramente interessante per la realizzazione di programmi aderenti alla filosofia principe di Sun Write Once Run Evrywhere. Anche se non era impossibile prima, adesso lutilizzazione di JDBC permette in tutta semplicità di estendere le informazioni contenute in un database ad una rete estesa non omogenea (intranet/internet) senza dover compiere notevoli sforzi; linterazione del mondo del lavoro con complessi e grossi archivi è uno dei fenomeni di maggior interesse nellinformatica moderna, e la lenta migrazione verso Internet, grazie sopratutto a Java, sta rivoluzionando notevolmente questo settore, un po stagnante negli ultimi tempi. Sembra proprio che le previsioni di Giudici nel suo articolo apparso in MokaByte di ottobre 96.siano state quanto mai appropriate: riferendosi a Java infatti sembra che ...dopo un po' di anni di monotonia e la lenta ma apparentemente inesorabile marcia verso un futuro grigio ed uniforme, l'ambiente è di nuovo vivace come verso la metà degli anni '80 (anzi, di più!) ed il futuro decisamente più interessante.. .
Le funzionalità messe a disposizione da Java e dalle JDBC permettono di eseguire tutte le operazioni classiche che siamo abituati ad effettuare su un database, come ad esempio stabilire una connessione con un database residente su un host remoto o sulla macchina locale, inviare istruzioni SQL per modificare i dati, analizzare i risultati ottenuti dalla particolare istruzione. Le JDBC offrono contemporaeamente un buon livello di interfaccia utente, e contemporanemente, un completo supporto verso il basso a contatto col DBMS utilizzato.
Modelli 2-Tier e 3-Tier
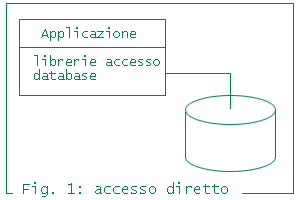
Prima di parlare di modelli a 2 e tre strati facciamo una breve premessa: supponiamo di avere una base di dati e di dover accedere a tale archivio da un certo programma. Il modo più semplice per far questo è quello di interfacciare direttamente il programma con il database per mezzo di un set di librerie opportune. Ovviamente questo tipo di organizzazione è indicata solo nel caso si debba accedere ai dati in locale e non si debba tener conto di problematiche come condivisione dell'informazione ed accesso multiplo all'archivio. In tal caso allora un tale schema è troppo semplice, e si deve prendere in considerazione un modello distribuito.
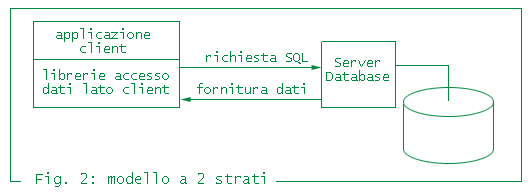
Una delle grosse innovazioni nel modo di concepire ed organizzare le strutture informatiche, é stato quella di passare da strutture fortemente centralizzate, ad una più razionale distribuzione delle risorse e, sopratutto, dei fornitori di servizi. La diffusione ormai inarrestabile dello standard Client/Server ha permesso, tra le altre cose, una gestione delle informazioni contenute in database, più facile e coerente. Questo tipo di architettura é chiamata a volte Modello a 2 strati - 2 Tier Model, in quanto costituito da un programma client (primo livello) che interagisce con un server su cui risiede ad esempio il database (secondo livello). Da notare che in questo caso il server svolge solo un compito on demand, in quanto oltre alle ordinarie operazioni di manutenzione, di coordinamento degli accessi e di fornitura dei dati richiesti, non intraprende nessuna iniziativa autonoma dagli altri protagonisti della architettura, come invece può accadere nel modello a 3 strati.
Passato lentusiasmo iniziale riguardo ad internet, si è iniziato a comprendere le reali effettive potenzialità di questo mezzo: si è infatti andato sempre più diffondendo la convinzione che la grande rete, oltre che essere un qualcosa di straordinariamente grande e potente, può essere considerato in modo molto più semplice come una connessione di rete un po più estesa rispetto alla normale LAN dellufficio. Parole come Intranet e web office si sono affacciate sullo scenario informatico, introducendo nuove ed avanzatissime potenzialità, ma complicando contemporaneamente tutto quello che stà intorno allaccesso alla rete. Il concetto stesso di Clente Servente a due strati si è mostrato inadeguato per soddisfare tutte le esigenze che le nuove tecnologie richiedono. Questo discorso ovviamente richiederebbe maggiore ampliamento, ma in questa sede ci serve solo per far capire che le nuove realtà hanno richiesto nuove soluzioni.
Modello a tre strati
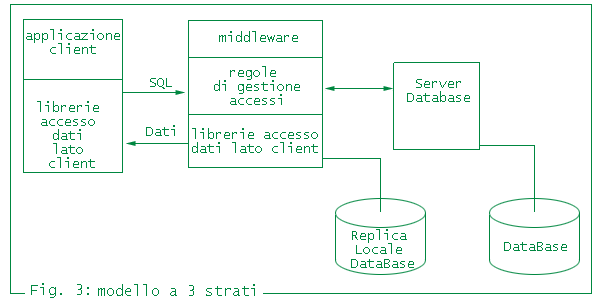
Cosa fare quindi se due strati non bastano più? La cosa più semplice è ovviamente introdurne un terzo che sinteticamente potremmo dire ha il compito di coordnirare il flusso delle informazioni richieste da client diversi in relazione ad archivi diversi fra loro e sopratutto situati su macchine dislocate in varie zone del mondo. La suddivisione in tre livelli permette di aumentare il livello di specializzazione delle varie componenti: supponiamo ad esempio di avere un client un database ed un modulo intermedio che gestisce il traferiemento dei dai dal client al database. Il client potrebbe essere ad esempio unapplet Java, che, dovendosi occupare solo di colloquiare con lutente e di inviare messaggi verso il server intermedio, non si deve preoccupare di implementare anche tutta la gestione dellaccesso ai dati. Questo punto infatti è il maggior inconveniente dellarchitettura Client Server: in genere è necessario che accanto alla parte di interfacciamento con lutente, deve risiedere anche tutto il software necessario alla connessione, per cui o si integra tali funzionalità nel cliente (scrivendo a mano il driver), compito lungo, faicoso e difficile, o si esegue un download del driver ad ogni esecuzione dellapplet (come avviene ad esempio con ActiveX), cosa molto costosa e non semplice, anche se può avvenire in modo del tutto trasparente agli occhi dellutente. Chiunque abbia provato a scrivere un semplicissimo programma in VB per accedere ad un archivio remoto (es Access mdb), si sarà reso conto come a volte i maggiori probvlemi non derivino dal client stesso, ma dai driver ODBC che devono risiedere anche sul PC cliente. La comodità di delegare al server intermedio la comunicazione col DBMS, permette di utilizzare per la comunicazione fra il client e lo strato intermedio un protocollo standard di comunicazione , (es CORBA, RMI o anche il semplice HTTP), o uno progettato appositamente per lo scopo (vedi articolo di Bobbi apparso in MokaByte Marzo 97), ma in ogni modo slegato dalle problematiche relative ad una particolare base di dati: si potrà quindi prelevare e modificare dati da db diversi senza di volta in volta cambiare la sintassi dei vari statements. Se si pensa al linguaggio SQL che dovrebbe essere standard, ma che molto spesso invece presenta vari sottodialetti, si capisce limportanza di una tale soluzione, che permette quindi di accedere ai dati presenti sul database da ogni macchina su cui sia disponibile un browser Java-enabled. La parte di codice relativa al DBMS e quindi al db segue le regole standard di comunicazione col mondo esterno (SQL, recordset, query,...). Non è necessario quindi dilungarsi oltre su questa sezione, se non per dire che il punto fondamentale è che in questo caso il db non è direttamente collegato col client ma segue le richieste del server intermedio.
Infine lo strato intermedio dove risiede il cosiddetto server di servizio: in questa porzione di codice si devono implementare tutte le funzionalità di colloquio col client da un lato, e col DBMS da laltro. Questa maggiore modularizzazione permette da un lato una più semplice implementazione e manutenzione di tutti le parti, ed al contempo permette di semplificare gli sforzi per la realizzazione delle varie politiche di controllo e di sicurezza, dato che in questo caso si ha un solo punto daccesso alla base di dati In questottica più client possono accedere allo stesso database, come accade in una tipico sistema client server, ma il server del middleware può mettere a disposizione allo stesso client dati, che sono residenti in databse diversi su machine diverse fra loro. Se il server implementa tecniche multithread può servire contemporaneamente più client che inviano istruzioni, o servire contemporaneamente più richieste del client, con un indiscutibile aumento delle prestazioni.
Il mese prossimo
Per questo mese possiamo congedarci qui: nel prosimo numero entreremo nei dettagli tecnici legati a JDBC vedendo ad esmpio cosa succede effettivamente quando si consulta una tabella di un database da una pagina html.