
Questo è il primo di tre articoli che avranno come obiettivo lo sviluppo di un interprete di espressioni. Nel corso di questi articoli si affronteranno tematiche di teoria di linguaggi e tecniche di compilazione; verranno inoltre descritte alcune classi Java, che saranno impiegate nel corso dellimplementazione: java.io.StreamTokenizer, java.util.HashTable, java.util.Vectore java.util.Stack.
La funzione dellinterprete è quella di accertare la validità delle espressioni e calcolare il risultato di esse. La verifica delle espressioni viene fatta attraverso le diverse fasi di analisi: lessicale, sintattica e semantica; nel calcolo invece intervengono la generazione e lesecuzione di codice. La distribuzione delle diverse fasi nei tre articoli è la seguente:
1. Analisi lessicale 2. Analisi sintattica 3. Analisi semantica, generazione ed esecuzione di codice.
Ogni articolo avrà un applet dimostrativo delle tematiche che sono state affrontate.
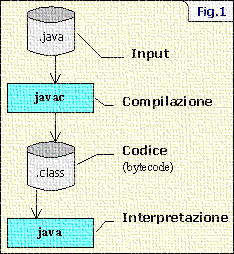
La realizzazione di qualsiasi interprete prevede principalmente due processi di elaborazione: compilazione e interpretazione. Nella compilazione si verifica che linput sia conforme alle specifiche del linguaggio per il quale è stato disegnato, e si genera il codice che rappresenta questo input. Nel processo di interpretazione viene eseguito il codice generato in compilazione. Se prendiamo Java come esempio di interprete, possiamo vedere, nella figura 1, che questi processi sono ben definiti. La maggioranza degli interpreti seguono questo schema, solo una minoranza di essi svolgono direttamente le azioni man mano che analizzano linput. Cè da segnalare che in alcuni interpreti (es. Java) il codice, prima di venire eseguito, viene verificato contro eventuali errori o manomissioni.
Le fasi del processo di compilazione sono le seguenti:
1. Analisi lessicale: verifica che i caratteri di input appartengano allinsieme (alfabeto) di caratteri permessi dal linguaggio; inoltre consegna i tokens (v. definizione di seguito) allanalizzatore sintattico. 2. Analisi sintattica: controlla che linput soddisfi le regole grammaticali del linguaggio. 3. Analisi semantica: verifica lesistenza di eventuali errori semantici come la concordanza dei tipi con gli operatori, la dichiarazione delle variabili, ecc. 4. Generazione di codice intermedio: genera il codice intermedio corrispondente allinput accettato. 5. Ottimizzazione del codice: tenta di migliorare in velocità e/o in spazio il codice generato nella fase precedente. Alcune di queste ottimizzazioni sono triviali, come per esempio leliminazione di espressioni costanti allinterno delle espressioni (es. 10\*2+x+2è uguale a 22+x). 6. Generazione di codice: fase finale dove viene generato il codice per il target (processore o interprete) a partire da quello ottimizzato.
Nel nostro caso specifico non avremmo le fasi di generazione di codice intermedio e ottimizzazione, anche se non escludo la possibilità di esporre in un altro articolo leliminazione di espressioni costanti allinterno delle espressioni.
In un linguaggio certe combinazioni di caratteri vengono trattate come singole entità. Alcuni esempi di queste possono essere: numeri, identificatori, operatori a più di un carattere come "&&", ecc. Il lavoro di un analizzatore lessicale è quello di estrarre queste singole entità, chiamate tokens, escludendo quei caratteri che non hanno un preciso significato (es. spazi, tabulazioni, ecc.). Le premesse per costruire un analizzatore lessicale sono le seguenti:
- Definizione dellalfabeto di caratteri del linguaggio (es. \[+,\*,0..9\]).
- Definizione dei tipi di tokens (es. numero, variabile, operatore, ecc.).
Le espressioni tipo per questo interprete potranno contenere: numeri con punto decimale, variabili, associazione con parentesi, e operazioni di moltiplicazione, somma, sottrazione e divisione. Alcuni esempi sono: a, -var+2, 4-2, 4.5 \ (x+333), Base_Somma \ percentuale / 100.
Di seguito vengono riportate le definizioni formali di alfabeto e token per queste espressioni.
> Alfabeto: \[ 0..9 \| a..z \| A..Z \| \_ \| + \| - \| \* \| / \| ( \| ) \| \| \t \| \r \| \n \].
Tipi di tokens sopportati:
- Operatore: \[ \*, + , - , / \]
- Numero: \[ 0..9 \]+ \[ . \]\* \[ 0..9 \]+ (es. 9, 123, 2.45, .4)
- Simbolo: \[ '(' , ')' \]
- Variabile: \[ 'A'..'Z' , 'a'..'z' , '\' \] \[ 'A'..'Z' , 'a'..'z' , '\' , 0..9 \]\*(es. x, val, \x, v12, y32_old)
Adesso possiamo procedere con la definizione delle classi Java che rappresentano i diversi tipi di tokens. Innanzitutto dobbiamo definire una super classe che raggruppi tutti i tipi di tokens e che ne detenga lidentificatore di tipo di token.
18
class GenericToken {

19
public static final int SYMBOL = 0;

20
public static final int VARIABLE = 1;

21
public static final int NUMBER = 2;

22
public static final int OPERATOR = 3;

23
public static final int EOE = 4;

25
int tk_type;

26

28
public GenericToken( int _tk_type ) {

29
tk_type = _tk_type;

30
}

32
public int getType() {

33
return tk_type;

34
}

36
public String toString() {

37
String s;

38

39
switch (getType()) {

40
case SYMBOL:   s = "SIMBOLO  "; break;

41
case VARIABLE: s = "VARIABILE"; break;

42
case NUMBER:   s = "NUMERO   "; break;

43
case OPERATOR: s = "OPERATORE"; break;

44
case EOE:      s = "FINE DI ESPRESSIONE"; break;

45
default: s = "NONE";

46
}

48
return s;

49
}

50
}
Allinizio della classe si trovano le costanti che rappresentano i diversi tipi di token. Lidentifcatore EOEci serve per rilevare la fine della espressione. Il metodo toString() ci fornisce una rappresentazione a caratteri del tipo di token, e può essere utilizzato per inserire delle tracce allinterno del programma.
Dichiarazione delle classe derivanti da GenericToken.
53
class SymbolToken extends GenericToken {

54
char symbol;

55

56
public SymbolToken( char _symbol ) {

57
super(SYMBOL);

58
symbol = _symbol;

59
}

61
public char getSymbol() {

62
return symbol;

63
}

65
public String toString() {

66
return super.toString()+" -> "+"\""+getSymbol()+"\"";

67
}

68
}

71

72
class NumberToken extends GenericToken {

73
double val;

74

75
public NumberToken( double _val ) {

76
super(NUMBER);

77
val = _val;

78
}

80
public double getValue() {

81
return val;

82
}

84
public String toString() {

85
return super.toString()+" -> "+String.valueOf(getValue());

86
}

87
}

89

90
class VariableToken extends GenericToken {

91
String varname;

92

93
public VariableToken( String _varname ) {

94
super(VARIABLE);

95
varname = _varname;

96
}

98
public String getName() {

99
return varname;

100
}

102
public String toString() {

103
return super.toString()+" -> "+getName();

104
}

105
}

107

108
class OperatorToken extends GenericToken {

109
public static final int ADD = 0;

110
public static final int SUB = 1;

111
public static final int MUL = 2;

112
public static final int DIV = 3;

113
public static final int MINUS = 4;

115
int op;

116

117
public OperatorToken( int _op ) {

118
super(OPERATOR);

119
op = _op;

120
}

122
public int getOp() {

123
return op;

124
}

126
public int getArity() {

127
switch (getOp()) {

128
case ADD: return 2;

129
case SUB: return 2;

130
case MUL: return 2;

131
case DIV: return 2;

132
case MINUS: return 1;

133
default: return 0;

134
}

135
}

137
public double doOp( NumberToken left, NumberToken right ) throws ArithmeticException
{


138
switch (getOp()) {

139
case ADD: return left.getValue()+right.getValue();

140
case SUB: return left.getValue()-right.getValue();

141
case MUL: return left.getValue()*right.getValue();

142
case DIV:

143
if (right.getValue()==0)

144
throw new ArithmeticException();

145
else

146
return left.getValue()/right.getValue();

147
case MINUS: return -left.getValue();

148
default: return 0;

149
}

150
}

152
public String toString() {

153
String s;

154

155
switch (getOp()) {

156
case ADD  : s = "ADD(+)"; break;

157
case SUB  : s = "SUB(-)"; break;

158
case MUL  : s = "MUL(x)"; break;

159
case DIV  : s = "DIV(/)"; break;

160
case MINUS: s = "MINUS(-)"; break;

161
default: s = "NONE"; break;

162
}

164
return super.toString()+" -> "+s;

165
}

166
}

Tutte
le classi hanno una rappresentazione a caratteri delle loro proprietà
attraverso il metodo toString(). Il metodo OperatorToken.getArity (r.126)
fornisce la quantità di argomenti delloperatore. Il metodo OperatorToken.doOp(r.137)
realizzerà il calcolo assegnato alloperatore, prendendo come argomenti
i valori dei due tokens numerici passati come parametri; nel caso che loperatore
sia unitario, il parametro da prendere sarà il primo. E da notare
che loperatore MINUSnon ha nessuna rilevanza dal punto di vista lessicale
o sintattico, dato che la sua rappresentazione è uguale a SUB; il
suo utilizzo sarà necessario nella fase di generazione del codice.

Lanalizzatore
lessicale è stato implementato in una nuova classe chiamata LexicalAnalizer.
La spiegazione di questa classe sarà fatta attraverso i diversi
pezzi del suo codice.

169
class LexicalAnalizer {

170
StreamTokenizer st;

172

173
public LexicalAnalizer( InputStream is ) {

174
st = new StreamTokenizer(is);

175
st.lowerCaseMode(true);

176
st.ordinaryChar('/');

177
st.ordinaryChar('+');

178
st.ordinaryChar('-');

179
st.ordinaryChar('*');

180
st.ordinaryChar('.');

181
st.ordinaryChars(124,255);

182
st.wordChars('_','_');

183
st.eolIsSignificant(false);

184
}
Lunica variabile è un oggetto di tipo StreamTokenizer, il quale ci servirà come analizzatore lessicale primario. Il costruttore della classe riceve un InputStream dal quale verranno letti i caratteri nella classe StreamTokenizer(r.174). Le altre istruzioni servono ad aggiustare alcuni parametri che sono diversi da quelle di default, vediamoli di seguito con più dettaglio.
- lowerCaseMode(r.175) è stato messo a trueper convertire a minuscole le parole; in questo modo si ottiene di non fare distinzione tra maiuscole e minuscole nei nomi delle variabili.
- ordinaryChar(/) ordinaryChar(\)(r.176-179) servono a far ritornare questi caratteri come singole unità e non come parte di un'altra composizione lessicale (es. commenti /\ , numero negativo -, ecc.).
- ordinaryChar(.)(r.180) serve a far ritornare come singola unità il carattere '.'; con questo si riesce ad escludere questo carattere dai nomi delle variabili.
- ordinaryChars(124,255)(r.181) serve a far ritornare come singole unità i caratteri estesi; con questo si riesce ad escludere questi caratteri dai nomi delle variabili.
- wordChars(\,\) (r182) indica che il carattere \ formerà parte delle parole, permettendo così il riconoscimento delle variabili che contengono questo carattere (es. produzioneannuale). Le lettere dellalfabeto (es. A, a, B, ecc.) sono automaticamente definite come "wordChars" nel costruttore della classe.
- eolIsSignificant(false) (r183) fa considerare il cambio di riga come un spazio bianco da scartare.
185
public GenericToken nextToken()

186
throws IOException, LexicalError {

187
int t;

188

189
t = st.nextToken();

191
switch (t) {

192
case st.TT_EOF: return new GenericToken(GenericToken.EOE);

193
case st.TT_NUMBER: return new NumberToken(st.nval);

194
case st.TT_WORD: return new VariableToken(st.sval);

195
case '+': return new OperatorToken(OperatorToken.ADD);

196
case '-': return new OperatorToken(OperatorToken.SUB);

197
case '*': return new OperatorToken(OperatorToken.MUL);

198
case '/': return new OperatorToken(OperatorToken.DIV);

199
case '(': case ')': return new SymbolToken((char)t);

200
default: throw new LexicalError("Carattere non valido \'"+(char)t+"\' ("+t+").");

201
}

202
}
Il metodo StreamTokenizer.nextToken(r.189) ci ritorna il tipo del token appena analizzato. I valori possibili per questo ritorno sono:
- TT_EOF: si è arrivati alla fine dellInputStream.
- TT_EOL: si è arrivati alla fine della riga.
- TT_WORD: è stato trovata una sequenza di caratteri ("parola") appartenenti allinsieme di wordChars, e il suo valore si incontra nella variabile StreamTokenizer.sval.
- TT_NUMBER: è stato riconosciuto un numero, e il suo valore si trova nella variabile StreamTokenizer.nval.
Quando il tipo non è uguale a nessuno di questi, vuol dire che si tratta di uno dei caratteri definiti come "ordinary". Nel caso che un carattere non appartenga allalfabeto delle espressioni, viene sollevata leccezione LexicalError (r.200). Questa eccezione è stata definita come una semplice estensione di Exception, e ci servirà a distinguere la provenienza degli errori di compilazione.
Oltre allutilizzo che abbiamo fatto della classe StreamTokenizer, questa ci permette anche di riconoscere delle stringhe delimitate tra caratteri (es. "Questa è una stringa"). Per default il carattere delimitante è virgolette ("), ma può essere cambiato con il metodo quoteChar(int carattere). Quando una stringa viene riconosciuta, nextToken() ritorna il carattere delimitante e in svalviene depositata la stringa. Di seguito riportiamo un esempio con le stringhe Pascal (es. apostrofi).
Standard Input: questa è una stringa
Inizializzazione: quoteChar(\\;
Riconoscimento:
StreamTokenizer st = new StreamTokenizer(System.in);
int t;
t = st.nextToken();
if (t==\\ System.out.println(st.sval);
Standard Output: questa è una stringa
Con i metodi commentChar, slashSlashCommentse slashStarCommentssi può gestire la permissività di commenti allinterno dellinput. Consultare la documentazione dello JDK per un approfondimento di questi metodi.
Lutilizzo della classe LexicalAnalizerverrà esemplificato con lapplet che si trova di fianco. I caratteri di input allanalizzatore devono essere inseriti nella casella di testo sotto "Espressione". Per eseguire lanalisi premere Invionella casella o premere il pulsante "Analisi Lessicale". I token ottenuti ed eventuali messaggi di errore saranno visualizzati nella casella "Risultati". Il sucesso dell'analisi viene notificato con un messaggio nella barra di stato del browser.
Di seguito faremo i commenti ai frammenti più rilevanti dellapplet.
4
public class ex1 extends java.applet.Applet {

5
List    li;

6
TextField edExpr;

7

8
public void init() {

9
/* Creazione e disposizione dei componenti nell'applet.

10
Il codice non è stato inserito per ragioni di spazio

11
ma i sorgenti completi possono essere scaricati come

12
indicato alla fine dell'articolo.
*/

40
}

56
void addError( Exception e ) {

57
li.addItem(e.toString());

58
li.select(li.countItems()-1);

59
}

61
void doIt() {

62
LexicalAnalizer la;

63
GenericToken gt;

64
boolean success = false;

65

66
try {

67
la = new LexicalAnalizer(new StringBufferInputStream(edExpr.getText()));

68
li.clear();

69
gt = la.nextToken();

70
while (gt.getType()!=GenericToken.EOE) {

71
li.addItem(gt.toString());

72
gt = la.nextToken();

73
}

74
success = true;

75
}

76
catch (IOException e) getAppletContext().showStatus(e.toString());

77
catch (LexicalError e) addError(e);

78
if (success)

79
getAppletContext().showStatus("Operazione completata con successo");

80
else

81
getAppletContext().showStatus("Operazione interrotta per errore");

82
}

84
public boolean handleEvent(Event evt) {

86
switch (evt.id) {

87
case Event.ACTION_EVENT: {

88
if ("Analisi Lessicale".equals(evt.arg)) doIt();

89
break;

90
}

91
case Event.KEY_PRESS: {

92
if (evt.target instanceof TextField &&

93
evt.key == '\n' ) doIt();

94
break;

95
}

96
}

97
return false;

98
}

99
}
Nel metodo handleEvent(r.84) vengono catturati gli eventi di pressione del tasto Invioe del pulsante "Analisi Lessicale" per eseguire lanalisi nel metodo doIt (r.61).
La riga 67 crea una istanza della classe LexicalAnalizer usando come InputStreamil contenuto della casella "Espressione". Nella riga seguente viene pulito il contenuto della casella di elenco "Risultati". Dalla riga 69 alla 73 vengono aggiunti alla casella "Risultati", uno alla volta, tutti i tokens trovati. Se si verifica un errore, questo verrà catturato nelle istruzioni delle righe 76 e 77. La visualizzazione degli errori avviene con laggiunta del testo nella casella "Risultati" (r.57); dopodiché la riga viene selezionata (r.58) per garantire la sua visibilità. Le istruzioni finali del metododoIt(r.78-81) notificano, nella barra di stato, il successo delloperazione.
Come avrete notato, la semplicità e la compattezza di implementazione della classe LexicalAnalizersi deve in grande misura alla classe Java StreamTokenizer, che costituisce un potenziale strumento in compiti di analisi lessicale come quello affrontato nel nostro caso. Nel prossimo articolo potremo vedere lutilizzo, allinterno dellanalizzatore sintattico, della classe LexicalAnalizer.
Download
I sorgenti esposti possono essere scaricati ai seguenti indirizzi:
- http://www.infomedia.it//LexicalAnalizer.java (classi GenericToken, NumberToken, VariableToken, SymbolToken, OperatorToken e LexicalAnalizer).
- http://www.infomedia.it//ex1.java (applet di esempio).
Bibliografia
1. Documentazione API JDK 1.0.2 2. "The theory of parsing, translation, and compiling", V. Aho and Jeffrey D. Ullman, 1973; ISBN 0-13-914564-8 3. "Peter Nortons Guide to Java Programming", Peter Norton and William Stanek, 1996; ISBN 1-57521-088-6
Rafael Andrés Marín de la Cruz
Laureato in Matematica-Cibernetica allUniversità dellAvana (Cuba) nel 1990, da quattro anni vive e lavora a Milano. Con la sua società ha sviluppato software per non vedenti sotto DOS e un tool di installazione per Windows. Svolge inoltre consulenza, in qualità di progettista, nel campo delle telecomunicazioni. Il suo sito si trova al seguente indirizzo: <http://www.galactica.it/dialectica>.
Può essere contattato tramite la redazione o direttamente all'indirizzo: <dialectica.sas@galactica.it>